


בדף הזה מוסבר איך משתמשים בלוח הבקרה של Query Insights כדי לזהות ולנתח בעיות בביצועים של Spanner.
סקירה כללית של תובנות לגבי שאילתות
בעזרת התובנות לגבי שאילתות אפשר לזהות ולאבחן בעיות בביצועים של שאילתות והצהרות DML (INSERT, UPDATE ו-DELETE) במסד נתונים ב-Spanner. הוא תומך במעקב אינטואיטיבי ומספק מידע לאבחון שעוזר לכם לזהות את שורש הבעיה בביצועים, ולא רק לגלות אותה.
הכלי "תובנות לגבי שאילתות" עוזר לשפר את הביצועים של שאילתות Spanner באמצעות השלבים הבאים:
- לבדוק אם שאילתות לא יעילות גורמות לניצול גבוה של המעבד (CPU).
- מזהים שאילתה או תג שעלולים להיות בעייתיים.
- מנתחים את השאילתה או את תג הבקשה כדי לזהות בעיות.
התכונה "תובנות לגבי שאילתות" זמינה בהגדרות של אזור יחיד ומספר אזורים.
תמחור
השימוש בתובנות לגבי שאילתות לא כרוך בעלות נוספת.
שמירת נתונים
התובנות לגבי שאילתות שומרות נתונים למשך 30 ימים לכל היותר.
בתרשים Total CPU Utilization (per Query or Request tag), Spanner מאחזר נתונים מהטבלאות של SPANNER_SYS.QUERY_STATS_TOP_*. הטבלאות האלה נשמרות למשך 30 ימים לכל היותר. מידע נוסף זמין במאמר שמירת נתונים.
התפקידים הנדרשים
אתם צריכים תפקידים והרשאות שונים ב-IAM, בהתאם לסוג המשתמש שלכם: משתמש IAM או משתמש עם בקרת גישה פרטנית.
משתמש בניהול זהויות והרשאות גישה (IAM)
כדי לקבל את ההרשאות שדרושות לצפייה בדף תובנות של שאילתות, צריך לבקש מהאדמין להקצות לכם את התפקידים הבאים ב-IAM במכונה:
- צפייה ב-Cloud Spanner (
roles/spanner.viewer) - קריאה ממסד נתונים ב-Cloud Spanner (
roles/spanner.databaseReader)
כדי לצפות בדף Query Insights, נדרשות ההרשאות הבאות בתפקיד Cloud Spanner Database Reader (
roles/spanner.databaseReader):
spanner.databases.beginReadOnlyTransactionspanner.databases.selectspanner.sessions.create
משתמש עם בקרת גישה פרטנית
אם אתם משתמשים בבקרת גישה פרטנית, ודאו שאתם:
- צפייה ב-Cloud Spanner (
roles/spanner.viewer) - יש להם הרשאות לבקרת גישה פרטנית, והוקצה להם תפקיד המערכת
spanner_sys_readerאו אחד מהתפקידים שכלולים בו. - בדף הסקירה הכללית של מסד הנתונים, בוחרים את
spanner_sys_readerאו תפקיד של חבר בתור תפקיד המערכת הנוכחי.
מידע נוסף זמין במאמרים מידע על בקרת גישה מפורטת (FGAC) ותפקידי מערכת של בקרת גישה מפורטת (FGAC).
מרכז הבקרה של Query Insights
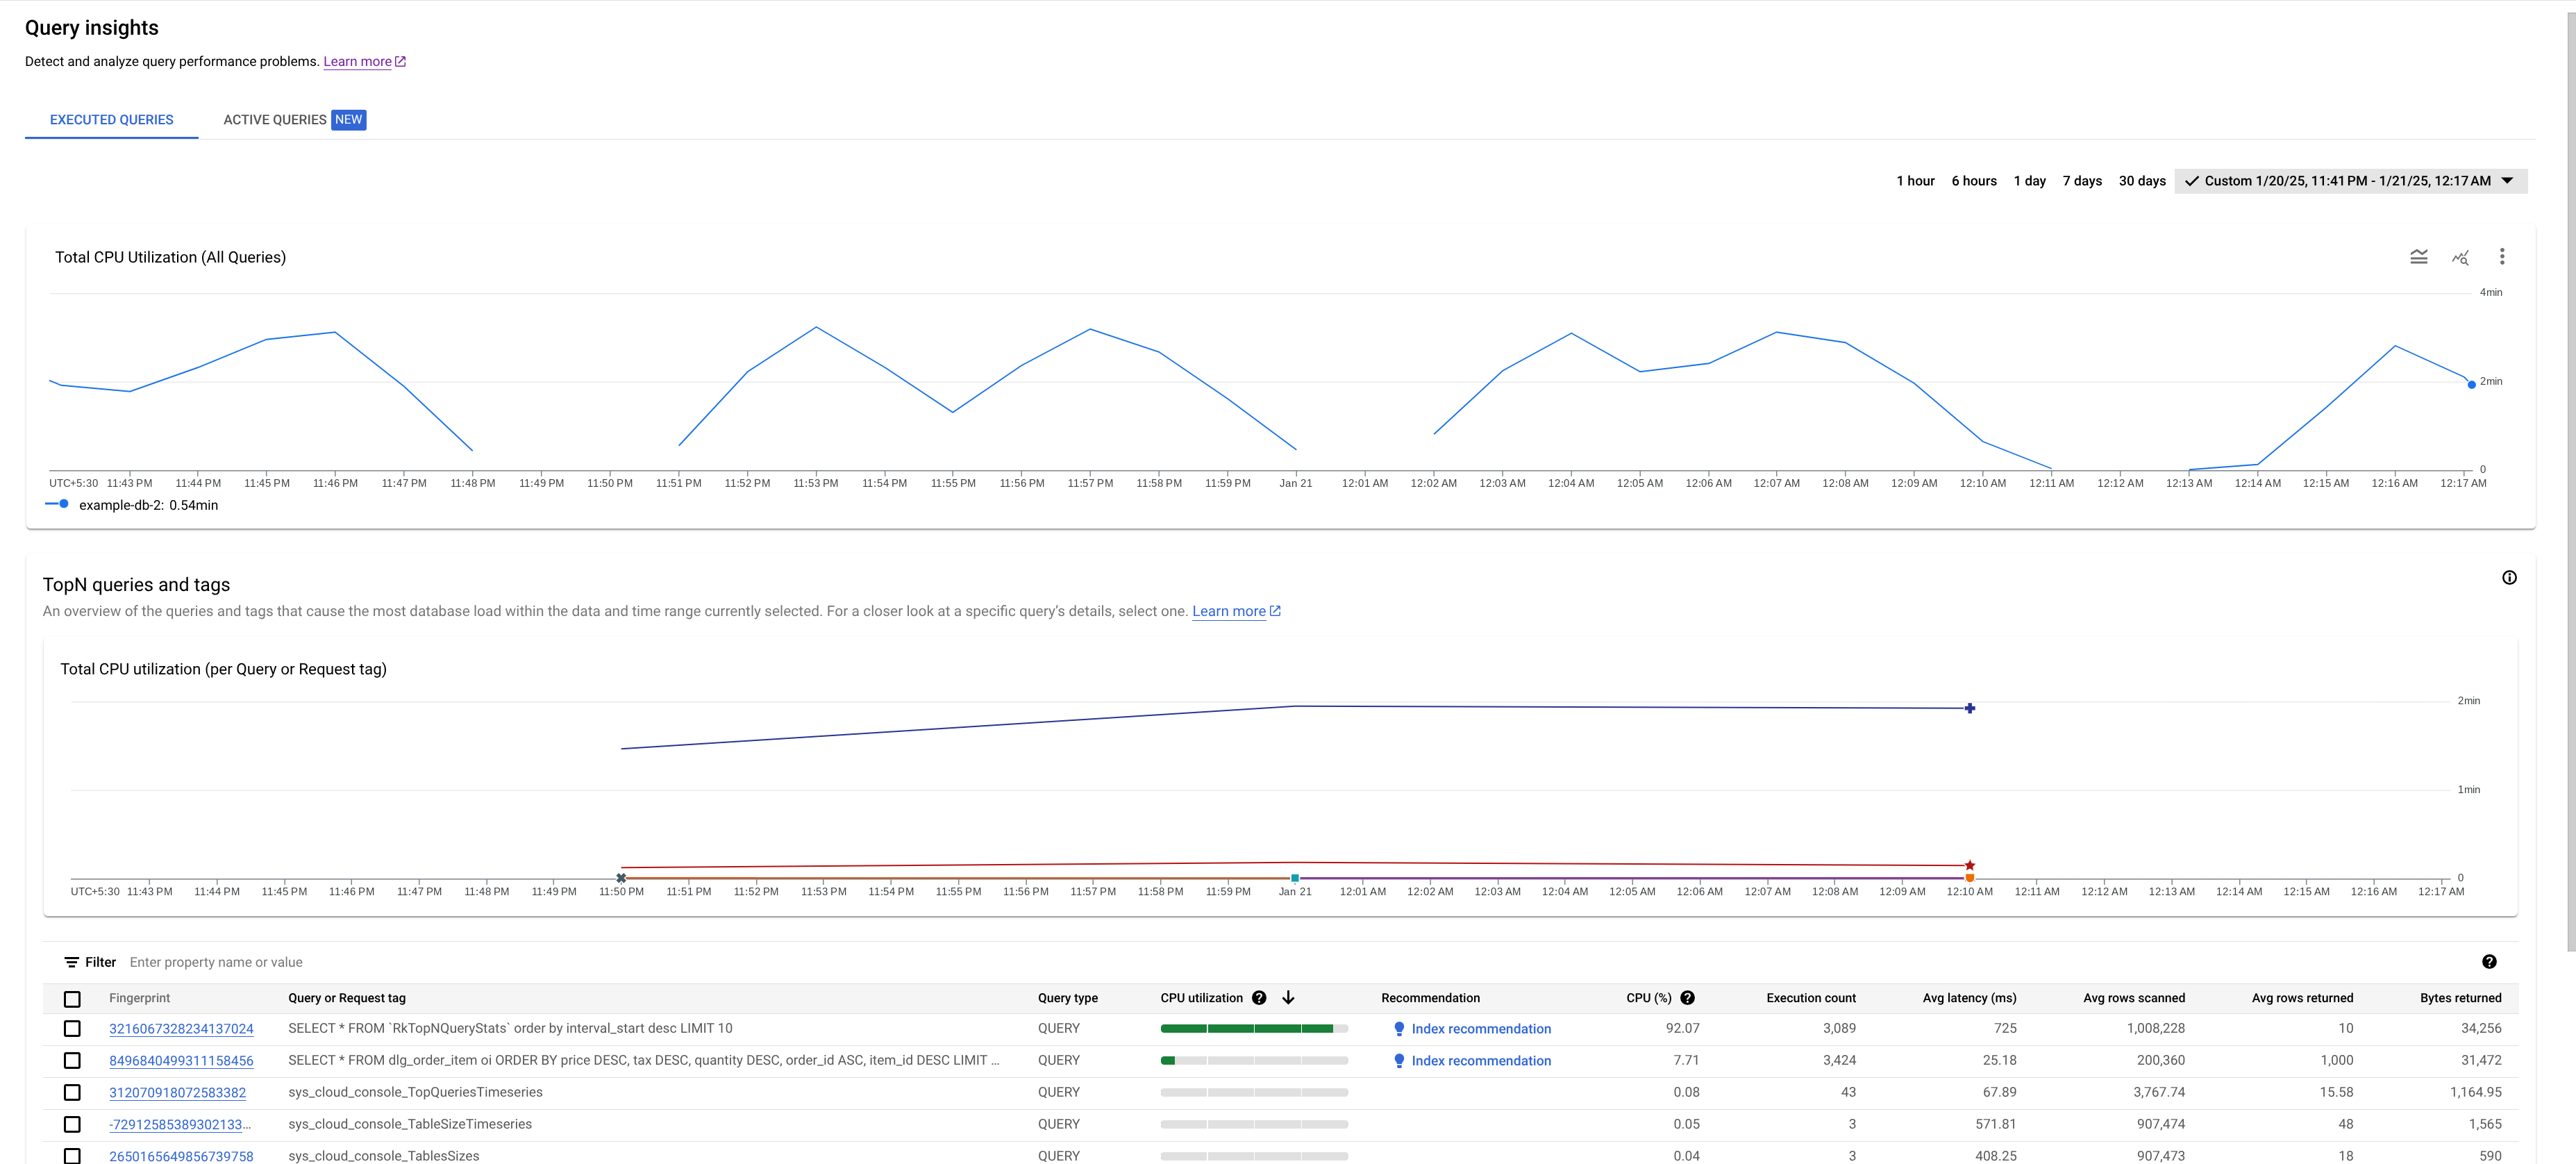
בלוח הבקרה של Query Insights מוצג עומס השאילתות בהתאם למסד הנתונים ולטווח התאריכים שבחרתם. עומס השאילתות הוא מדד של ניצול המעבד (CPU) הכולל של כל השאילתות במכונה בטווח תאריכים שנבחר. בלוח הבקרה יש כמה מסננים שמאפשרים לראות את עומס השאילתות.
כדי לפתוח את לוח הבקרה של Query Insights במסד נתונים:
- בחלונית הניווט שמימין, לוחצים על תובנות לגבי שאילתות. לוח הבקרה של Query Insights נפתח.
- בוחרים מסד נתונים מהרשימה Databases. בלוח הבקרה מוצג מידע על עומס השאילתות במסד הנתונים.
האזורים במרכז הבקרה כוללים את:
- Databases list: סינון עומס השאילתות במסד נתונים ספציפי או בכל מסדי הנתונים.
- מסנן טווח תאריכים: מסנן את עומס השאילתות לפי טווחי תאריכים, כמו שעות, ימים או טווח בהתאמה אישית.
- התרשים Total CPU Utilization (All queries): מציג את השיעור הממוצע המצטבר של השימוש במעבד (בשניות מעבד לדקה) בכל השאילתות.
- התרשים Total CPU Utilization (per Query or Request tag): מציג את קצב השימוש הממוצע במעבד (בשניות מעבד לדקה) לפי כל שאילתה או תג בקשה.
- טבלת השאילתות והתגים של TopN: רשימה של השאילתות והתגים המובילים של הבקשות, ממוינת לפי ניצול ה-CPU. זיהוי שאילתה או תג שעלולים להיות בעייתיים
ביצועי מרכז הבקרה
כדי לשפר את הביצועים של Query Insights, השתמשו בפרמטרים של שאילתות או תייגו את השאילתות. אם לא תגדירו פרמטרים או תגים לשאילתות, יכול להיות שיוחזרו יותר מדי תוצאות, והטבלה של השאילתות והתגים של TopN לא תיטען כמו שצריך.
איך בודקים אם שאילתות לא יעילות גורמות לניצול גבוה של המעבד (CPU)
המדד "ניצול כולל של המעבד" מייצג את השיעור הממוצע של השימוש במעבד (בשניות מעבד לדקה) שמתבצע לאורך זמן על ידי השאילתות שהופעלו במסד הנתונים שנבחר.

כדאי לעיין בתרשים כדי לבדוק את השאלות הבאות:
באיזה מסד נתונים יש עומס? כדי למצוא את מסדי הנתונים עם העומסים הגבוהים ביותר, בוחרים מסדי נתונים שונים מהרשימה Databases. כדי לגלות לאיזה מסד נתונים יש את העומס הגבוה ביותר, אפשר גם לעיין בתרשים CPU utilization - total של מסדי הנתונים במסוףGoogle Cloud .

האם ניצול המעבד (CPU) גבוה? האם יש עלייה חדה בגרף או שהוא גבוה לאורך זמן? אם ניצול המעבד (CPU) לא גבוה, הבעיה היא לא בשאילתות.
כמה זמן ניצול המעבד (CPU) גבוה? האם הוא עלה בחדות לאחרונה או שהוא גבוה באופן עקבי כבר זמן מה? אפשר להשתמש בבורר הטווח כדי לבחור תקופות שונות ולגלות כמה זמן הבעיה נמשכת. מגדילים את התצוגה כדי לראות את חלון הזמן שבו נצפו העליות החדות בעומס השאילתות. מקטינים את התצוגה כדי לראות עד שבוע אחד בציר הזמן.
אם רואים עלייה חדה או עלייה בגרף שתואמת לשימוש הכולל במעבד (CPU) של המכונה, סביר להניח שהסיבה לכך היא שאילתה אחת או יותר שצורכות הרבה משאבים. בשלב הבא, אתם יכולים להעמיק בתהליך ניפוי הבאגים על ידי זיהוי של שאילתה או תג בקשה שעלולים להיות בעייתיים.
זיהוי שאילתה או תג בקשה שעלולים להיות בעייתיים
כדי לזהות שאילתה או תג בקשה שעלולים להיות בעייתיים, בודקים את הקטע TopN queries:
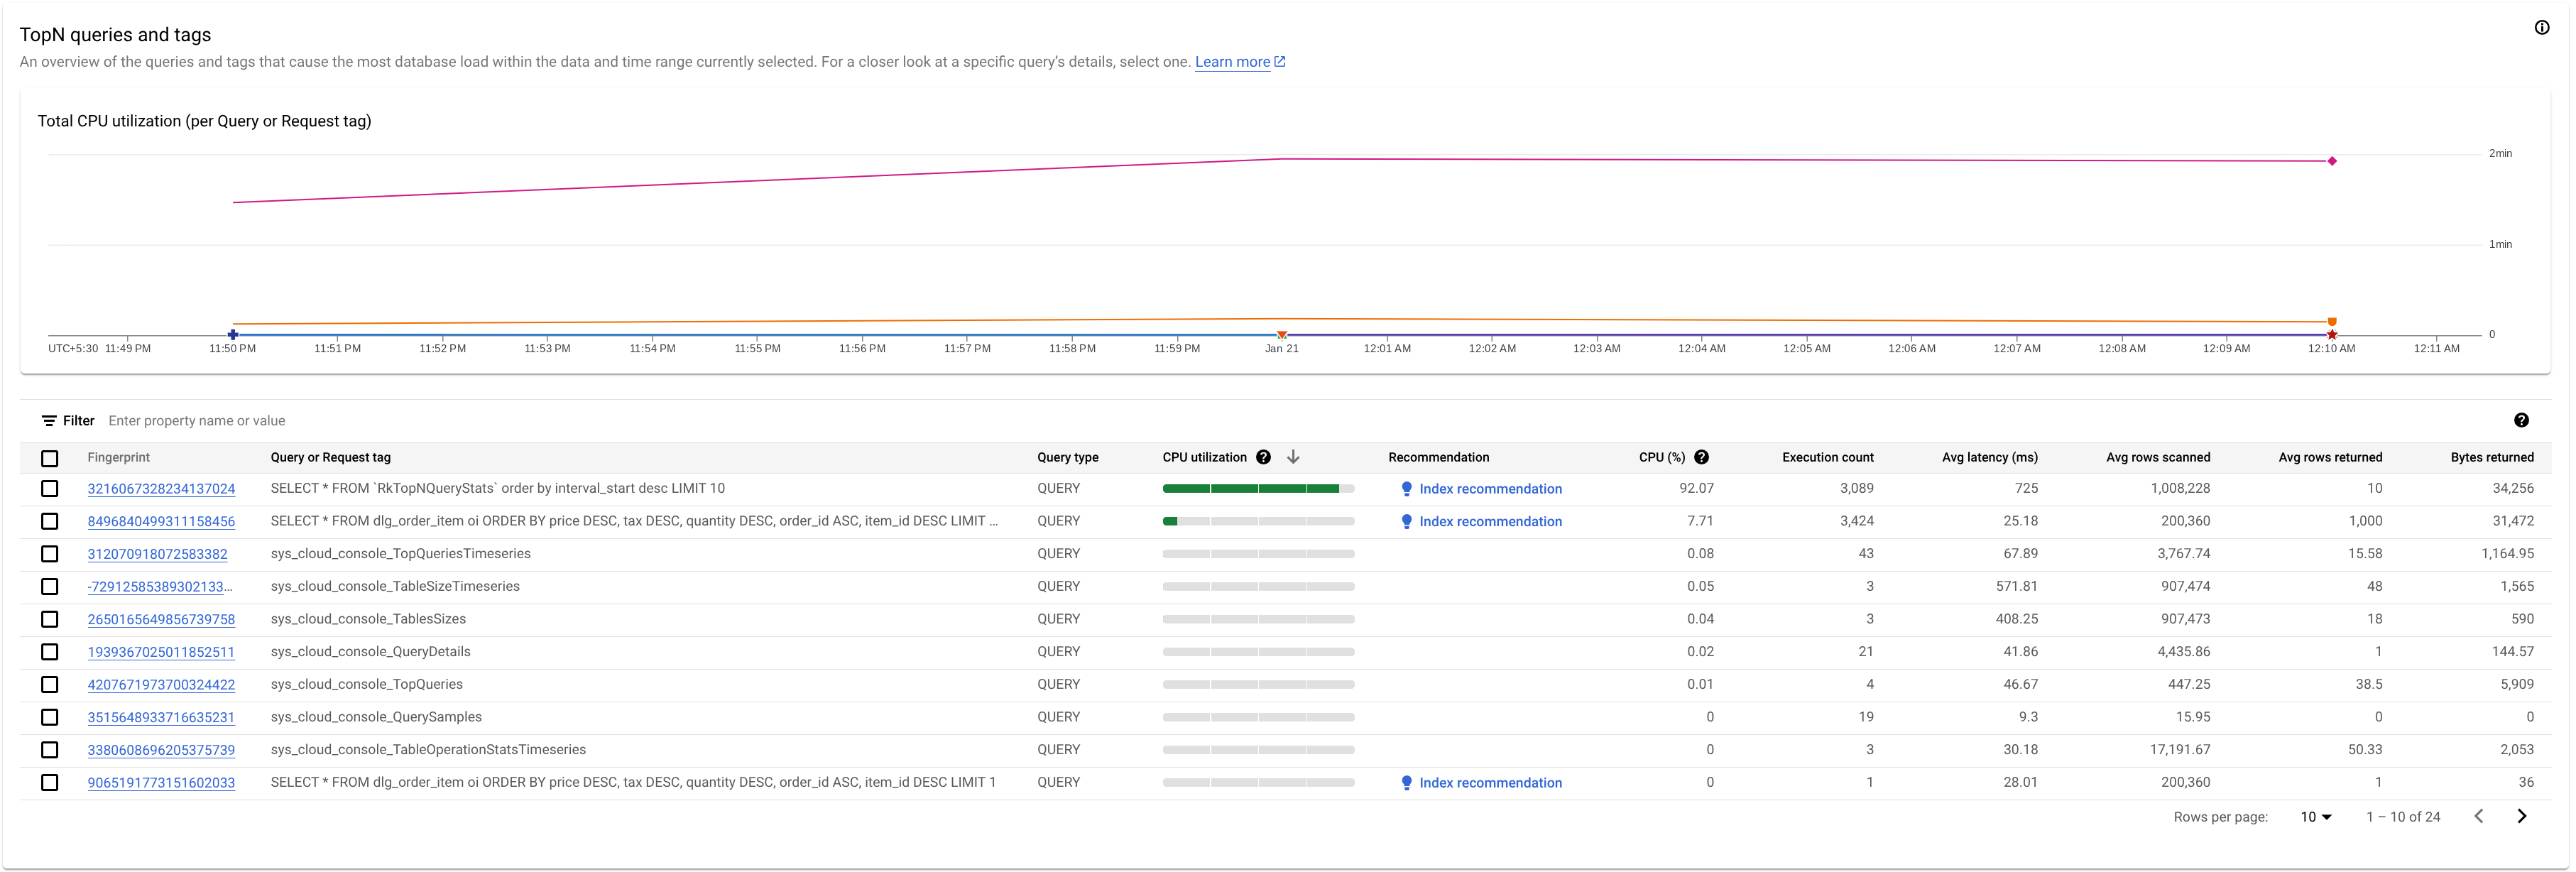
כאן אפשר לראות שלשאילתה עם טביעת האצבע 3216067328234137024 יש ניצול גבוה של המעבד (CPU) והיא יכולה להיות בעייתית.
בטבלה TopN queries מוצגת סקירה כללית של השאילתות שמשתמשות ב-CPU במידה הרבה ביותר במהלך חלון הזמן שנבחר, בסדר יורד. מספר השאילתות של TopN מוגבל ל-100.
הנתונים לתרשימים נשלפים מטבלת הנתונים הסטטיסטיים של שאילתות TopN, שכוללת שלוש רמות פירוט שונות: דקה אחת, 10 דקות ושעה אחת. הערך של כל נקודה על הגרפים מייצג את הערך הממוצע במרווח זמן של דקה אחת.
מומלץ להוסיף תגים לשאילתות SQL. תיוג שאילתות עוזר למצוא בעיות במבנים ברמה גבוהה יותר, כמו בלוגיקה העסקית או במיקרו-שירות.
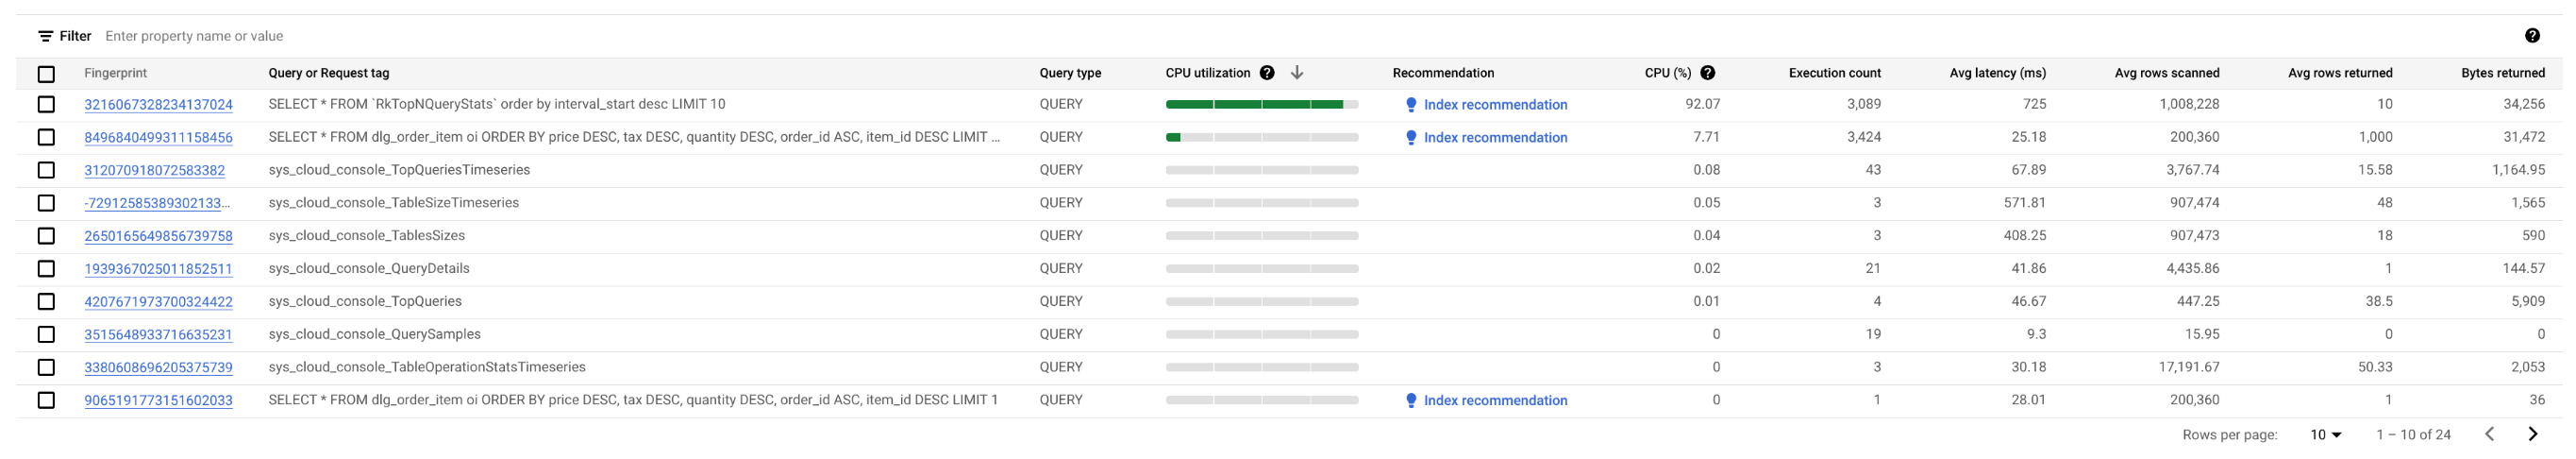
בטבלה מוצגים המאפיינים הבאים:
- טביעת אצבע: גיבוב (hash) של תג הבקשה, או אם התג לא קיים, גיבוב של טקסט השאילתה.
תג השאילתה או הבקשה: אם לשאילתה משויך תג, תג הבקשה מוצג. הנתונים הסטטיסטיים של כמה שאילתות עם אותה מחרוזת תג מקובצים בשורה אחת, שבה הערך של
REQUEST_TAGתואם למחרוזת התג. איך פותרים בעיות באמצעות תגי בקשות ותגי עסקאותאם לשאילתה אין תג משויך, מוצגת שאילתת ה-SQL, שנחתכת לכ-64KB. ב-DML באצווה, הצהרות ה-SQL משוטחות לשורה אחת ומחוברות באמצעות תו מפריד של נקודה פסיק. טקסטים זהים של SQL שמופיעים ברצף עוברים ביטול כפילויות לפני החיתוך.
סוג השאילתה: מציין אם השאילתה היא
PARTITIONED_QUERYאוQUERY.PARTITIONED_QUERYהיא שאילתה עםpartitionTokenשהתקבל מ-PartitionQuery API. כל שאר השאילתות ופקודות ה-DML מסומנות בסוג השאילתהQUERY.CPU Utilization: צריכת משאבי המעבד (CPU) על ידי שאילתה, כאחוז מסך משאבי המעבד שבהם משתמשות כל השאילתות שפועלות במסדי הנתונים במרווח הזמן הזה. הנתון מוצג בסרגל אופקי בטווח של 0 עד 100.
המלצה: המערכת של Spanner מנתחת את השאילתות כדי לקבוע אם אפשר לשפר אותן באמצעות אינדקסים משופרים. אם כן, הוא ממליץ על אינדקסים חדשים או משתנים שיכולים לשפר את ביצועי השאילתה. מידע נוסף זמין במאמר שימוש ב-Spanner index advisor.
CPU (%): צריכת משאבי המעבד (CPU) על ידי שאילתה, כאחוז מסך משאבי המעבד שבהם משתמשות כל השאילתות שפועלות במסדי הנתונים במרווח הזמן הזה.
מספר ההפעלות: הקצב הממוצע של הפעלות השאילתות, בהפעלות לדקה, ש-Spanner זיהה במהלך המרווח.
זמן אחזור ממוצע (במילי-שניות): משך הזמן הממוצע, במיקרו-שניות, לכל הרצת שאילתה במסד הנתונים. הממוצע הזה לא כולל את זמן הקידוד וההעברה של קבוצת התוצאות, וגם לא את התקורה.
Avg rows scanned: מספר השורות הממוצע שהשאילתה סרקה, לא כולל ערכים שנמחקו.
Avg rows returned: מספר השורות הממוצע שהשאילתה החזירה.
Bytes returned: מספר הבייטים של הנתונים שהשאילתה החזירה, לא כולל תקורה של קידוד השידור.
הבדלים אפשריים בין הגרפים
יכול להיות שיהיו הבדלים בין התרשים Total CPU Utilization (all queries) לבין התרשים Total CPU Utilization (per Query or Request tag). יש שתי סיבות אפשריות לתרחיש הזה:
מקורות נתונים שונים: הנתונים של Cloud Monitoring, שמזינים את התרשים Total CPU Utilization (all queries), בדרך כלל מדויקים יותר כי הם נשלחים כל דקה ונשמרים למשך 45 ימים. מצד שני, הנתונים בטבלת המערכת, שמזינים את התרשים Total CPU Utilization (per Query or Request tag), עשויים להיות ממוצעים של 10 דקות (או שעה), ובמקרה כזה יכול להיות שנאבד את הנתונים ברמת הפירוט הגבוהה שמופיעים בתרשים Total CPU Utilization (all queries).
חלונות צבירה שונים: לשני התרשימים יש חלונות צבירה שונים. לדוגמה, כשבודקים אירוע שנוצר לפני יותר מ-6 שעות, נשלחת שאילתה לטבלה
SPANNER_SYS.QUERY_STATS_TOTAL_10MINUTE. במקרה כזה, אירוע שמתרחש בשעה 10:01 יצטבר במשך 10 דקות ויופיע בטבלת המערכת שתואמת לחותמת הזמן 10:10.
בצילום המסך הבא מוצגת דוגמה להבדל כזה.

ניתוח של שאילתה או תג בקשה ספציפיים
כדי לקבוע אם תג שאילתה או תג בקשה הוא שורש הבעיה, לוחצים על תג השאילתה או תג הבקשה שנראה שיש לו את העומס הגבוה ביותר או שלוקח יותר זמן מהאחרים. אפשר לבחור כמה שאילתות ותגי בקשות בו-זמנית.
אפשר להעביר את סמן העכבר מעל התרשים של השאילתות בציר הזמן כדי לראות את ניצול ה-CPU שלהן (בשניות).
כדי לצמצם את הבעיה, נסו לבדוק את הדברים הבאים:
- כמה זמן העומס גבוה? האם הוא גבוה רק עכשיו? או שהוא גבוה כבר הרבה זמן? משנים את טווחי התאריכים כדי למצוא את התאריך והשעה שבהם הביצועים של השאילתה התחילו לרדת.
- האם היו עליות חדות בניצול המעבד (CPU)? אפשר לשנות את חלון הזמן כדי לבחון את השימוש ההיסטורי ב-CPU בשאילתה.
- מהי צריכת המשאבים? איך היא קשורה לשאילתות אחרות? מעיינים בטבלה ומשווים בין הנתונים של שאילתות אחרות לבין השאילתה שנבחרה. האם יש הבדל משמעותי?
כדי לוודא שהשאילתה שנבחרה תורמת לניצול הגבוה של המעבד, אפשר להציג פירוט של תבנית השאילתה הספציפית (או תג הבקשה) ולנתח אותה לעומק בדף הפרטים של השאילתה.
הצגת דף פרטי השאילתה
כדי לראות את הפרטים של תבנית שאילתה או תג בקשה ספציפיים בצורה גרפית, לוחצים על טביעת האצבע שמשויכת לשאילתה או לתג הבקשה. הדף פרטי שאילתה נפתח.

בדף Query Details מוצג המידע הבא:
- טקסט של פרטי השאילתה: טקסט של שאילתת SQL, מקוצר לכ-64KB. הנתונים הסטטיסטיים של כמה שאילתות עם אותה מחרוזת תג מקובצים בשורה אחת, שבה הערך של REQUEST_TAG תואם למחרוזת התג הזו. רק הטקסט של אחת מהשאילתות האלה מוצג בשדה הזה. ב-DML באצווה, קבוצת הצהרות ה-SQL משוטחת לשורה אחת, ומחוברת באמצעות מפריד נקודה-פסיק. טקסטים זהים של SQL שמופיעים ברצף עוברים ביטול כפילויות לפני החיתוך.
- הערכים של השדות הבאים:
- Execution count: הקצב הממוצע של הרצות השאילתות, בהרצות לדקה, ש-Spanner זיהה במהלך המרווח.
- Avg. CPU (ms): צריכת המשאבים הממוצעת של המעבד (CPU) באלפיות השנייה, לפי שאילתה של משאבי המעבד של המכונה במרווח זמן מסוים.
- זמן אחזור ממוצע (באלפיות השנייה): משך הזמן הממוצע, באלפיות השנייה, לכל הרצת שאילתה במסד הנתונים. הממוצע הזה לא כולל את זמן הקידוד וההעברה של קבוצת התוצאות ואת התקורה.
- מספר השורות הממוצע שהוחזרו: מספר השורות הממוצע שהשאילתה החזירה.
- מספר ממוצע של שורות שנסרקו: מספר השורות הממוצע שהשאילתה סרקה, לא כולל ערכים שנמחקו.
- Avg. bytes: מספר הבייטים של הנתונים שהשאילתה החזירה, לא כולל תקורה של קידוד השידור.
- תרשים דגימות של תוכניות לביצוע שאילתות: כל נקודה בתרשים מייצגת דגימה של תוכנית לביצוע שאילתה בזמן מסוים ואת זמן האחזור הספציפי של השאילתה. לוחצים על אחת מהנקודות בתרשים כדי לראות את תוכנית לביצוע שאילתה ולהמחיש את השלבים שבוצעו במהלך הרצת השאילתה. הערה: תוכניות לביצוע שאילתות לא נתמכות בשאילתות עם partitionTokens שהתקבלו מ-PartitionQuery API ובשאילתות DML מחולקות למחיצות.
המחשה חזותית של תוכנית לביצוע שאילתה: הצגת תוכנית לביצוע שאילתה שנדגמה ונבחרה. ב-Spanner יש את אפשרויות הפריסה הבאות:
- תצוגת עץ: בתצוגת העץ, התוכנית לביצוע השאילתה מוצגת כתרשים שבו כל צומת או כרטיס מייצגים איטרטור שצורך שורות מהקלט שלו ומפיק שורות להורה שלו. אפשר ללחוץ על כל איטרטור כדי לקבל מידע מורחב.
תצוגה רציפה: בתצוגה הרציפה, התוכנית לביצוע השאילתה מוצגת בטבלה היררכית שבה כל שורה מייצגת אופרטור. אפשר ללחוץ על כל שורה כדי להרחיב את המידע.

הטבלה כוללת את העמודות הבאות:
- שם: שם המפעיל.
- קבוצת מכונות: קבוצת המכונות שבה האופרטור הזה פעל.
- זמן אחזור: משך הזמן שחלף במהלך ביצוע הפעולה הנוכחית. יכול להיות שהזמן הזה יהיה ארוך יותר מזמן ה-CPU (לדוגמה, אם האופרטור המתין לשיחות מרחוק או לעיכוב במערכת הקבצים).
- זמן אחזור מצטבר: משך הזמן שחלף במהלך הביצוע של כל עץ המשנה שהשורש שלו הוא האופרטור הזה. הזמן הזה לא כולל את זמן יצירת התוכנית ועלויות תקורה אחרות, כך שהזמן המצטבר עשוי להיות קצר יותר מהמשך הכולל של השאילתה.
- זמן CPU: משך הזמן הכולל של ה-CPU שהושקע בהרצת השאילתה. לא כולל את זמן האחזור של הרשת. יכול להיות שחלקים מסוימים של הרצת השאילתה יתבצעו במקביל, ולכן יכול להיות שזמן ה-CPU יהיה ארוך יותר מהזמן הכולל שחלף. לדוגמה, אם שאילתה מבצעת עשר פעולות במקביל באלפית שנייה אחת, הזמן שחלף הוא אלפית שנייה אחת, אבל זמן ה-CPU הוא 10 אלפיות השנייה.
- שורות שהוחזרו: מספר השורות שהוחזרו על ידי האופרטור.
תרשים זמן האחזור של השאילתה: מציג את ערך זמן האחזור של שאילתה שנבחרה לאורך תקופה מסוימת. מוצג גם זמן האחזור הממוצע.
תרשים ניצול המעבד (CPU): מציג את ניצול המעבד על ידי שאילתה, באחוזים, לאורך תקופה מסוימת. הוא גם מציג את ניצול המעבד (CPU) הממוצע.
תרשים מספר ההפעלות/ההפעלות שנכשלו: מציג את השיעור הממוצע של הפעלות השאילתות (בהפעלות לדקה) לאורך תקופה, ואת השיעור הממוצע של הפעלות השאילתות שנכשלו (בהפעלות שנכשלו לדקה).
תרשים השורות שנסרקו: מציג את מספר השורות שהשאילתה סרקה במהלך תקופה מסוימת.
התרשים Rows returned: מציג את מספר השורות שהשאילתה החזירה במהלך תקופה מסוימת.
מסנן טווח תאריכים: מסנן את פרטי השאילתה לפי טווחי תאריכים, כמו שעה, יום או טווח בהתאמה אישית.
הנתונים לתרשימים נשלפים מטבלת הנתונים הסטטיסטיים של שאילתות TopN, שכוללת שלוש רמות פירוט שונות: דקה אחת, 10 דקות ושעה אחת. הערך של כל נקודה על הגרפים מייצג את הערך הממוצע במרווח זמן של דקה אחת.
חיפוש כל ההפעלות של שאילתה ביומן הביקורת
כדי לחפש את כל ההפעלות של טביעת אצבע של שאילתה מסוימת ביומני הביקורת של Cloud, שולחים שאילתה ליומן הביקורת ומחפשים את כל הערכים של query_fingerprint שתואמים לשדה Fingerprint בטבלת הנתונים הסטטיסטיים של שאילתות TopN. מידע נוסף זמין במאמר סקירה כללית על שאילתות ויומני תצוגה. אתם יכולים להשתמש בשיטה הזו כדי לזהות את המשתמש שהפעיל את השאילתה.