


בדף הזה מתואר הקונספט המתקדם של סשנים ב-Spanner, כולל שיטות מומלצות לסשנים כשיוצרים ספריית לקוח, כשמשתמשים ב-API ל-REST או ל-RPC, או כשמשתמשים בספריות הלקוח של Google.
סשן מספק הקשר לפעולות במסד הנתונים באמצעות שירות מסד הנתונים של Spanner. סשן משמש לביצוע טרנזקציות שקוראות, כותבות או משנות נתונים במסד נתונים של Spanner. כל סשן חל על מסד נתונים אחד.
בסשנים אפשר לבצע טרנזקציה אחת או יותר בכל פעם. כשמבצעים כמה עסקאות, הסשן נקרא סשן מרובה עסקאות. פעולות קריאה, כתיבה ושאילתות עצמאיות משתמשות בטרנזקציה אחת באופן פנימי.
ניהול הביצועים של הסשנים
הסשנים הם ההקשר של פעולת מסד הנתונים, ולכן האופן שבו אתם מנהלים אותם משפיע ישירות על זמן האחזור ועל השימוש במשאבים של האפליקציה. אתם יכולים לנהל את ביצועי הסשנים בשלוש הדרכים הבאות:
שימוש במאגר סשנים
יצירת סשן מוסיפה זמן אחזור כי כל סשן חדש דורש נסיעה הלוך ושוב לשירות מסד הנתונים של Spanner. כדי לצמצם את זמן האחזור, אפשר להשתמש במאגר סשנים: אוסף של סשנים זמינים שמוכנים לשימוש. במקום ליצור סשן לכל פעולה, המאגר מחזיר סשן קיים ומחזיר אותו לשימוש חוזר לאחר מכן. כך זמן האחזור של יצירת הסשן מתפרס על פני פעולות רבות, במקום לבטל אותו לחלוטין. המאגר שומר סשנים קיימים, מחזיר את סוג הסשן המתאים כשמבקשים ומנקה סשנים שלא בשימוש.
הסשנים אמורים להיות ארוכים, לכן אחרי שמשתמשים בסשן לפעולה במסד הנתונים, הלקוח צריך להחזיר את הסשן למאגר כדי להשתמש בו שוב.
שימוש בסשנים מרובי-ערוצים
סשנים מרובי-ערוצים מאפשרים לשלוח כמה בקשות מקבילות בסשן אחד, וכך להפחית את התקורה של הקצה העורפי ואת צריכת המשאבים. מידע נוסף זמין במאמר סשנים מרובי-ערוצים.
אופטימיזציה של הגדרת הערוץ של gRPC
כדי לצמצם את זמן האחזור הגבוה (p95/p99) שנגרם בגלל עומס בערוץ gRPC בזמן תנועה גבוהה, אפשר לשנות את מאגר ערוצי ה-gRPC. בספריות לקוח נתמכות, מאגר הערוצים הדינמי משנה באופן אוטומטי את גודל מאגר הערוצים בהתאם לשינויים בעומס. כך אפשר לצמצם את זמן האחזור שקשור לעומס, ולהימנע מהקצאת יתר או מהקצאת חסר של ערוצים.
סקירה כללית על ערוצי gRPC
ערוצי gRPC משמשים את לקוח Spanner לתקשורת. ערוץ gRPC אחד שווה ערך בערך לחיבור TCP. ערוץ gRPC אחד יכול לטפל בעד 100 בקשות מקבילות. כלומר, האפליקציה תצטרך מספר ערוצי gRPC ששווה לפחות למספר הבקשות שהאפליקציה תבצע בו-זמנית, חלקי 100.
כשיוצרים לקוח Spanner, הוא יוצר מאגר של ערוצי gRPC.
שיטות מומלצות לשימוש בספריות הלקוח של Google
כאן מפורטות השיטות המומלצות לשימוש בספריות הלקוח של Google ל-Spanner.
הגדרת מספר הסשנים וערוצי ה-gRPC במאגרים
האופן שבו מנהלים סשנים וערוצי gRPC תלוי בספריית הלקוח. בספריות לקוח שתומכות בסשנים מרובי-ערוצים, כמו ספריות הלקוח של Go ו-Java, לא צריך להגדיר מאגר סשנים, והן יכולות לנהל בשבילכם את מאגר הערוצים של gRPC באמצעות איחוד ערוצים דינמי. בספריות הלקוח האחרות נעשה שימוש במאגר סשנים עם מספר מינימלי ומקסימלי של סשנים כברירת מחדל, ובמספר ערוצי gRPC כברירת מחדל. ערכי ברירת המחדל מתאימים לרוב המקרים. בקטעים הבאים מתוארות אפשרויות ברירת המחדל וההגדרות האישיות לכל שפת תכנות.
C++
MinSessions: 100
MaxSessions: 400
NumChannels: 4
C#
MinSessions: 100
MaxSessions: 400
NumChannels: 4
המשך
סשנים מרובי-ערוצים מופעלים כברירת מחדל ולא נדרשת הגדרה.
התכונה 'מאגר ערוצים דינמי' היא תכונת הצטרפות. אם לא תפעילו אותה, הלקוח ישתמש בארבעה ערוצי gRPC. כדי להשתמש במספר קבוע אחר של ערוצי gRPC, משתמשים באפשרות option.WithGRPCConnectionPool כשיוצרים את הלקוח:
// Use 16 gRPC channels instead of the default of four.
client, err := spanner.NewClient(ctx,
    "projects/PROJECT_ID/instances/INSTANCE_ID/databases/DATABASE_ID",
    option.WithGRPCConnectionPool(16),
)
בדוגמה הזו נדרשת החבילה google.golang.org/api/option.
כדי להפעיל מאגר ערוצים דינמי, מגדירים את האפשרות DCPEnabled ל-true ב-DynamicChannelPoolConfig:
client, err := spanner.NewClientWithConfig(ctx,
    "projects/PROJECT_ID/instances/INSTANCE_ID/databases/DATABASE_ID",
    spanner.ClientConfig{
        DynamicChannelPoolConfig: spanner.DynamicChannelPoolConfig{
            DCPEnabled: true,
        },
    })
כשמפעילים מאגר דינמי של ערוצים בלי להגדיר אפשרויות בהתאמה אישית, ספריית הלקוח של Go מחילה את ברירות המחדל הבאות:
- גודל מאגר ראשוני: 4 ערוצים
- גודל מאגר מינימלי: 2 ערוצים
- גודל מאגר מקסימלי: 10 ערוצים
- סף להגדלת קנה המידה: 25 קריאות RPC בו-זמניות לכל ערוץ
- סף לצמצום אנכי בהתאם לעומס (scale down): 15 קריאות RPC בו-זמניות לכל ערוץ
- מרווח הזמן לבדיקת צמצום אנכי בהתאם לעומס (scale down): 3 דקות
כדי להתאים אישית את המאגר, מגדירים את השדות של המבנה DynamicChannelPoolConfig, כמו DCPInitialChannels, DCPMinChannels, DCPMaxChannels, DCPMaxRPCPerChannel ו-DCPMinRPCPerChannel.
Java
סשנים מרובי-ערוצים מופעלים כברירת מחדל בגרסה 6.98.0 ואילך של ספריית הלקוח של Java, ולא נדרשת הגדרה. מידע נוסף זמין במאמר סשנים מרובי-ערוצים.
מאגר הערוצים הדינמי מושבת כברירת מחדל בספריית הלקוח של Java, וצריך להפעיל אותו באמצעות SpannerOptions. אם לא מפעילים את מאגר הערוצים הדינמי, ספריית הלקוח של Java משתמשת ב-4 ערוצי gRPC (או ב-8 ערוצים כשמפעילים את התוסף gRPC-GCP). כשהתכונה הזו מופעלת, ספריית הלקוח משנה את הגודל של מאגר הערוצים של gRPC בהתאם לעומסי העבודה המשתנים, כדי למנוע בעיות בביצועים שנובעות מהקצאת חסר או הקצאת יתר של ערוצים.
כדי להפעיל מאגר ערוצים דינמי, צריך לכלול את enableDynamicChannelPool ב-SpannerOptions:
SpannerOptions options =
    SpannerOptions.newBuilder()
        .setProjectId("PROJECT_ID")
        .enableDynamicChannelPool()
        .build();
אם מגדירים את מספר הערוצים באמצעות setNumChannels, Spanner משבית את מאגר הערוצים הדינמי ומשתמש במספר סטטי של ערוצים.
כשמפעילים מאגר ערוצים דינמי בלי להגדיר אפשרויות בהתאמה אישית באמצעות setGcpChannelPoolOptions, ספריית הלקוח של Java מחילה את הגדרות ברירת המחדל הבאות, שמותאמות לעומסי עבודה אופייניים:
- גודל מאגר ראשוני: 4 ערוצים
- גודל מאגר מינימלי: 2 ערוצים
- גודל המאגר המקסימלי: 10 ערוצים (מגבלה קשיחה: 256 ערוצים)
- סף להגדלת קנה המידה: 25 קריאות RPC בו-זמניות לכל ערוץ
- סף לצמצום אנכי בהתאם לעומס (scale down): 15 קריאות RPC בו-זמניות לכל ערוץ
- מרווח הזמן לצמצום אנכי בהתאם לעומס (scale down): 3 דקות
כדי להתאים אישית את מאגר הערוצים הדינמי, משתמשים ב-setGcpChannelPoolOptions. לדוגמה:
SpannerOptions options =
    SpannerOptions.newBuilder()
        .setProjectId("PROJECT_ID")
        .enableDynamicChannelPool()
        .setGcpChannelPoolOptions(
            GcpChannelPoolOptions.newBuilder()
                .setMaxSize(15)
                .setMinSize(3)
                .setInitSize(5)
                // setDynamicScaling(minRpcPerChannel, maxRpcPerChannel,
                // scaleDownInterval): scale up as soon as a channel's load
                // exceeds 30 concurrent RPCs. Scale-up is event-driven, so
                // the pool grows immediately as load rises. Scale-down is
                // periodic: a channel is removed only after it stays under
                // 10 concurrent RPCs across the check that runs every 5
                // minutes.
                .setDynamicScaling(10, 30, Duration.ofMinutes(5))
                .build())
        .build();
כדאי לשקול את היתרונות והחסרונות הבאים של מאגר ערוצים דינמי:
- תקורה של התאמה לעומס (scaling): התאמה לעומס של המאגר כוללת תקורה מיצירה והשמדה של ערוצי gRPC וחיבורי TCP. לעומסי עבודה שרגישים לזמן אחזור עם פרצים חדים, יכול להיות שעדיף לבחור במאגר סטטי גדול כדי להימנע מזמן אחזור של התאמה לעומס.
- שינוי הגדרות ברירת המחדל: הגדרת מספר הערוצים הבסיסי משביתה את איגוד הערוצים הדינמי. מידע נוסף זמין במאמר
setNumChannels. - שימוש במשאבים: מאגר ערוצים סטטי משתמש בכמות קבועה של זיכרון וחיבורים, ואילו השימוש במשאבים של מאגר דינמי משתנה בהתאם לעומס.
Node.js
סשנים רגילים
סשנים מרובי-ערוצים מופעלים כברירת מחדל בגרסה 8.3.0 ואילך, ואין צורך להגדיר אותם. בגרסאות קודמות, כברירת מחדל נעשה שימוש בסשנים רגילים, עם ההגדרות הבאות:
MinSessions: 25
MaxSessions: 100
איחוד ערוצים
איחוד דינמי של ערוצים מופעל כברירת מחדל עם ההגדרות הבאות:
MaxChannels: 10
ConcurrentRequestsPerChannel: 25
אתם יכולים לשנות את ההגדרות באופן פרוגרמטי כשאתם יוצרים מכונה של לקוח Spanner.
אם משתמשים בסשנים מרובי-ערוצים (ברירת המחדל)
מעתיקים את ההגדרה של channelPool מהגדרת Spanner gRPC לאפליקציה. אין צורך להעתיק הגדרות של שיטות והגדרות של שיוך, כי סשנים מרובי-ערוצים לא דורשים קישור בין הסשן לערוץ.
לדוגמה:
const {Spanner} = require('@google-cloud/spanner');
    // Note: Ensure grpcGcp is initialized
const customGcpApiConfig = {
  channelPool: {
    maxSize: 20, // Overriding default 10
    maxConcurrentStreamsLowWatermark: 50 // Overriding default 25
  }
};
const spanner = new Spanner({
  'grpc.gcpApiConfig': grpcGcp.createGcpApiConfig(customGcpApiConfig)
});
אם אתם משתמשים בסשנים רגילים
מעתיקים את ההגדרה המלאה (גם channelPool וגם שיוכי השיטות) מהגדרת Spanner gRPC לאפליקציה. השמטת ה-method affinities עלולה לפגוע בביצועים כי הבקשות מאבדות את הקישור בין הסשן לערוץ.
PHP
לקוח ה-PHP לא תומך במספר ערוצי gRPC שניתן להגדיר.
MinSessions: 1
MaxSessions: 500
Python
Python תומכת בארבעה סוגים שונים של מאגרי סשנים שבהם אפשר להשתמש כדי לנהל סשנים.
Ruby
הלקוח של Ruby לא תומך בכמה ערוצי gRPC. לכן מומלץ ליצור כמה לקוחות במקום להגדיל את מאגר הסשנים מעבר ל-100 סשנים ללקוח אחד.
MinSessions: 10
MaxSessions: 100
אם ספריית הלקוח של שפת התכנות שלכם תומכת בסשנים מרובי-ערוצים, כדאי להשתמש בהם. סשנים מרובי-ערוצים לא דורשים הגדרה, וסשן מרובה-ערוצים אחד יכול לבצע כל מספר של טרנזקציות בו-זמנית.
מספר הסשנים שהאפליקציה משתמשת בהם שווה למספר הטרנזקציות שהאפליקציה מבצעת בו-זמנית. כדאי לשנות את הגדרות ברירת המחדל של מאגר הסשנים רק אם אתם צופים שמופע יחיד של אפליקציה יבצע יותר טרנזקציות בו-זמניות ממה שמאגר הסשנים יכול לטפל בו.
באפליקציות עם רמת בו-זמניות גבוהה, מומלץ:
- מגדירים את
MinSessionsלמספר הצפוי של עסקאות בו-זמניות שלקוח אחד יבצע. - מגדירים את
MaxSessionsלמספר המקסימלי של טרנזקציות בו-זמניות שלקוח אחד יכול לבצע. - אם מספר הבקשות בו-זמנית לא צפוי להשתנות הרבה במהלך חיי האפליקציה, מגדירים את
MinSessions=MaxSessions. כך מאגר הסשנים לא יגדל או יקטן. גם הגדלה או הקטנה של מאגר הסשנים צורכת משאבים. - מגדירים את
NumChannelsלהיותMaxSessions / 100. ערוץ gRPC אחד יכול לטפל בעד 100 בקשות בו-זמנית. אם אתם מבחינים בזמן אחזור גבוה (זמן אחזור p95/p99), כדאי להגדיל את הערך הזה, כי זה יכול להצביע על עומס בערוץ gRPC.
הגדלת מספר הסשנים הפעילים צורכת משאבים נוספים בשירות מסד הנתונים של Spanner ובספריית הלקוח. הגדלת מספר הסשנים מעבר לצורך בפועל של האפליקציה עלולה לפגוע בביצועי המערכת.
הגדלת מאגר הסשנים לעומת הגדלת מספר הלקוחות
גודל מאגר הסשנים של אפליקציה קובע כמה טרנזקציות בו-זמניות מופע יחיד של אפליקציה יכול לבצע. לא מומלץ להגדיל את מאגר הסשנים מעבר למספר המקסימלי של פעולות בו-זמניות שמופע יחיד של אפליקציה יכול לטפל בהן. אם האפליקציה מקבלת פרץ של בקשות שחורג ממספר הסשנים במאגר, הבקשות נכנסות לתור וממתינות עד שסשן יהיה זמין.
אלה המשאבים שספריית הלקוח משתמשת בהם:
- כל ערוץ gRPC משתמש בחיבור TCP אחד.
- כל הפעלה של gRPC דורשת שרשור. מספר השרשורים המקסימלי שבו משתמשת ספריית הלקוח שווה למספר המקסימלי של שאילתות בו-זמניות שהאפליקציה מבצעת. השרשורים האלה מתווספים לשרשורים שהאפליקציה משתמשת בהם ללוגיקה העסקית שלה.
לא מומלץ להגדיל את מאגר הסשנים מעבר למספר השרשורים המקסימלי שמופע אפליקציה יחיד יכול לטפל בו. במקום זאת, הגדילו את מספר המכונות של האפליקציה.
ניהול החלק של סשנים של כתיבה
בחלק מספריות הלקוח, Spanner שומר חלק מהסשנים לעסקאות קריאה וכתיבה, שנקרא write-sessions fraction. אם האפליקציה משתמשת בכל הסשנים לקריאה, Spanner משתמש בסשנים לקריאה ולכתיבה, גם לטרנזקציות לקריאה בלבד. סשנים של קריאה וכתיבה דורשים את ההרשאה spanner.databases.beginOrRollbackReadWriteTransaction. אם המשתמש משויך לתפקיד spanner.databaseReader ב-IAM, הקריאה נכשלת ו-Spanner מחזיר את הודעת השגיאה הבאה:
generic::permission_denied: Resource %resource% is missing IAM permission:
spanner.databases.beginOrRollbackReadWriteTransaction
בספריות הלקוח ששומרות על חלק מסוים של סשנים לכתיבה, אפשר להגדיר את החלק הזה.
C++
כל הסשנים של C++ זהים. אין סשנים לקריאה בלבד או לקריאה וכתיבה בלבד.
C#
חלק ברירת המחדל של סשני הכתיבה ב-C# הוא 0.2. אפשר לשנות את החלק באמצעות השדה WriteSessionsFraction של SessionPoolOptions.
המשך
כל הסשנים של Go זהים. אין סשנים לקריאה בלבד או לקריאה וכתיבה בלבד.
Java
כל הסשנים של Java זהים. אין סשנים לקריאה בלבד או לקריאה וכתיבה בלבד.
Node.js
כל הסשנים של Node.js זהים. אין סשנים לקריאה בלבד או לקריאה וכתיבה בלבד.
PHP
כל הסשנים של PHP זהים. אין סשנים לקריאה בלבד או לקריאה וכתיבה בלבד.
Python
Python תומכת בארבעה סוגים שונים של מאגרי סשנים שבהם אפשר להשתמש כדי לנהל סשנים של קריאה ושל קריאה וכתיבה.
Ruby
חלק ברירת המחדל של סשנים לכתיבה ב-Ruby הוא 0.3. אפשר לשנות את החלק באמצעות השיטה initialize של client.
שיטות מומלצות ליצירת ספריית לקוח או לשימוש ב-REST או ב-RPC
בהמשך מתוארות שיטות מומלצות להטמעת סשנים בספריית לקוח של Spanner, או לשימוש בסשנים עם ממשקי ה-API של REST או RPC.
השיטות המומלצות האלה רלוונטיות רק אם אתם מפתחים ספריית לקוח, או אם אתם משתמשים בממשקי API ל-REST או ל-RPC. אם אתם משתמשים באחת מספריות הלקוח של Google ל-Spanner, עיינו במאמר שיטות מומלצות לשימוש בספריות הלקוח של Google.
יצירה וקביעת הגודל של מאגר הסשנים
כדי לקבוע את הגודל האופטימלי של מאגר הסשנים לתהליך לקוח, מגדירים את הגבול התחתון למספר הטרנזקציות הצפויות בו-זמנית, ואת הגבול העליון למספר בדיקה ראשוני, כמו 100. אם הגבול העליון לא מספיק, מגדילים אותו. הגדלת מספר הסשנים הפעילים צורכת משאבים נוספים בשירות מסד הנתונים של Spanner, ולכן אם לא מנקים סשנים שלא בשימוש, הביצועים עלולים להיפגע. למשתמשים שעובדים עם RPC API, מומלץ לא להשתמש ביותר מ-100 סשנים לכל ערוץ gRPC.
טיפול בסשנים שנמחקו
יש שלוש דרכים למחוק סשן:
- הלקוח יכול למחוק סשן.
- שירות מסד הנתונים של Spanner יכול למחוק סשן אם הוא לא פעיל במשך יותר משעה.
- יכול להיות ששירות מסד הנתונים של Spanner ימחק סשן אם הוא נוצר לפני יותר מ-28 ימים.
ניסיונות להשתמש בסשן שנמחק יגרמו לשגיאה NOT_FOUND. אם נתקלתם בשגיאה הזו, צרו סשן חדש והשתמשו בו, הוסיפו את הסשן החדש למאגר והסירו את הסשן שנמחק מהמאגר.
איך לשמור על סשן לא פעיל
שירות מסד הנתונים של Spanner שומר לעצמו את הזכות למחוק סשן שלא נעשה בו שימוש. אם אתם חייבים להשאיר סשן לא פעיל, למשל אם צפויה עלייה משמעותית בשימוש במסד הנתונים בטווח הקרוב, אתם יכולים למנוע את סגירת הסשן. מבצעים פעולה פשוטה, כמו הרצת שאילתת ה-SQL SELECT 1, כדי לשמור על הסשן פעיל. אם יש לכם סשן לא פעיל שלא נדרש לשימוש בטווח הקרוב, תנו ל-Spanner למחוק את הסשן, ואז צרו סשן חדש בפעם הבאה שיהיה צורך בסשן.
תרחיש אחד שבו כדאי להשאיר סשנים פעילים הוא כדי לטפל בביקוש שיא קבוע במסד הנתונים. אם מסד הנתונים נמצא בשימוש כבד מדי יום בין השעות 9:00 ל-18:00, כדאי להשאיר כמה סשנים לא פעילים פתוחים במהלך הזמן הזה, כי סביר להניח שהם יידרשו לשימוש בשיא. אחרי השעה 18:00, אתם יכולים לאפשר ל-Spanner לסגור סשנים לא פעילים. לפני השעה 09:00 בכל יום, צרו כמה סשנים חדשים כדי שיהיו מוכנים לביקוש הצפוי.
תרחיש נוסף הוא אם יש לכם אפליקציה שמשתמשת ב-Spanner, אבל אתם צריכים להימנע מהתקורה של החיבור כשהיא עושה זאת. אפשר להשאיר קבוצה של סשנים פעילים כדי להימנע מהתקורה של החיבור.
הסתרת פרטי הסשן מהמשתמש בספריית הלקוח
אם אתם יוצרים ספריית לקוח, אל תחשפו סשנים לצרכן של ספריית הלקוח. הלקוח יכול לבצע קריאות למסד הנתונים בלי המורכבות של יצירת סשנים ותחזוקה שלהם. לדוגמה של ספריית לקוח שמסתירה את פרטי הסשן מהצרכן של ספריית הלקוח, ראו את ספריית הלקוח של Spanner ל-Java.
טיפול בשגיאות בעסקאות כתיבה שהן לא אידמפוטנטיות
עסקאות כתיבה ללא הגנה מפני הפעלה חוזרת עשויות להחיל מוטציות יותר מפעם אחת.
אם מוטציה היא לא אידמפוטנטית, מוטציה שמוחלת יותר מפעם אחת עלולה לגרום לכשל. לדוגמה, יכול להיות שהוספה תיכשל עם השגיאה ALREADY_EXISTS, למרות שהשורה לא הייתה קיימת לפני ניסיון הכתיבה. זה יכול לקרות אם שרת בק-אנד ביצע את הפעולה לשינוי נתונים אבל לא הצליח להעביר את ההצלחה ללקוח. במקרה כזה, יכול להיות שהמוטציה תופעל שוב, מה שיגרום לשגיאה ALREADY_EXISTS.
כך אפשר לטפל בתרחיש הזה כשמטמיעים ספריית לקוח משלכם או משתמשים ב-API בארכיטקטורת REST:
- מבנה הכתיבה צריך להיות אידמפוטנטי.
- משתמשים בכתיבה עם הגנה מפני הפעלה חוזרת.
- מטמיעים שיטה שמבצעת לוגיקה של "עדכון או הוספה (upsert)": הוספה אם מדובר בפריט חדש או עדכון אם הפריט קיים.
- לטפל בשגיאה בשם הלקוח.
שמירה על חיבורים יציבים
כדי ליהנות מהביצועים הטובים ביותר, החיבור שבו אתם משתמשים לאירוח סשן צריך להיות יציב. כשהחיבור שמארח סשן משתנה, יכול להיות ש-Spanner יבטל את הטרנזקציה הפעילה בסשן ויגרום לעומס קל נוסף על מסד הנתונים בזמן שהוא מעדכן את המטא-נתונים של הסשן. זה בסדר אם כמה חיבורים משתנים באופן ספורדי, אבל כדאי להימנע ממצבים שבהם מספר גדול של חיבורים משתנה בו-זמנית. אם אתם משתמשים בשרת proxy בין הלקוח ל-Spanner, אתם צריכים לשמור על יציבות החיבור בכל סשן.
מעקב אחרי סשנים פעילים
אתם יכולים להשתמש בפקודה ListSessions כדי לעקוב אחרי סשנים פעילים במסד הנתונים משורת הפקודה, באמצעות ה-API בארכיטקטורת REST או באמצעות ה-API ל-RPC. השאילתה ListSessions מציגה את הסשנים הפעילים במסד נתונים מסוים. האפשרות הזו שימושית אם אתם צריכים למצוא את הסיבה לדליפת סשן. (זליגת סשנים היא אירוע שבו נוצרים סשנים אבל הם לא מוחזרים למאגר הסשנים לשימוש חוזר).
ב-ListSessions אפשר לראות מטא-נתונים על הסשנים הפעילים, כולל מתי הסשן נוצר ומתי השתמשו בו לאחרונה. ניתוח הנתונים האלה יעזור לכם לפתור בעיות בסשנים. אם לרוב הסשנים הפעילים אין approximate_last_use_time עדכני, יכול להיות שהאפליקציה לא עושה שימוש חוזר בסשנים כמו שצריך. למידע נוסף על השדה approximate_last_use_time, קראו את מאמרי העזרה של RPC API.
למידע נוסף על השימוש ב-ListSessions, אפשר לעיין במאמרי העזרה של ה-API בארכיטקטורת REST, במאמרי העזרה של ה-API ל-RPC או במאמרי העזרה של כלי שורת הפקודה של gcloud.
ניקוי אוטומטי של דליפות סשנים
כשמשתמשים בכל הסשנים במאגר הסשנים, כל טרנזקציה חדשה ממתינה עד שסשן מוחזר למאגר. כשסשנים נוצרים אבל לא מוחזרים למאגר הסשנים לשימוש חוזר, זה נקרא דליפת סשנים. כשיש זליגת סשנים, טרנזקציות שממתינות לסשן פתוח נתקעות ללא הגבלת זמן וחוסמות את האפליקציה. זליגות של סשנים נגרמות בדרך כלל בגלל טרנזקציות בעייתיות שפועלות במשך זמן רב מאוד ולא מתבצעות.
אתם יכולים להגדיר את מאגר הסשנים כך שיפתור באופן אוטומטי את הטרנזקציות הלא פעילות האלה. כשמפעילים את ספריית הלקוח כדי לפתור באופן אוטומטי טרנזקציות לא פעילות, היא מזהה טרנזקציות בעייתיות שעלולות לגרום לדליפת סשנים, מסירה אותן ממאגר הסשנים ומחליפה אותן בסשן חדש.
רישום ביומן יכול גם לעזור לזהות את העסקאות הבעייתיות האלה. אם הרישום ביומן מופעל, יומני האזהרות משותפים כברירת מחדל כשנעשה שימוש ביותר מ-95% ממאגר הסשנים. אם השימוש בסשנים גדול מ-95%, צריך להגדיל את מספר הסשנים המקסימלי המותר במאגר הסשנים, או שיש דליפת סשנים. יומני האזהרות מכילים דוחות קריסות של טרנזאקציות שפועלות יותר זמן מהצפוי, ויכולים לעזור לזהות את הסיבה לניצול הגבוה של מאגר הסשנים. יומני האזהרות נשלחים בהתאם להגדרות של ייצוא היומנים.
הפעלת ספריית הלקוח כדי לפתור באופן אוטומטי טרנזקציות לא פעילות
אתם יכולים להפעיל את ספריית הלקוח כדי לשלוח יומני אזהרות ולפתור באופן אוטומטי טרנזקציות לא פעילות, או להפעיל את ספריית הלקוח כדי לקבל רק יומני אזהרות.
Java
כדי לקבל יומני אזהרות ולהסיר טרנזקציות לא פעילות, משתמשים ב-setWarnAndCloseIfInactiveTransactions.
 final SessionPoolOptions sessionPoolOptions = SessionPoolOptions.newBuilder().setWarnAndCloseIfInactiveTransactions().build()

 final Spanner spanner =
         SpannerOptions.newBuilder()
             .setSessionPoolOption(sessionPoolOptions)
             .build()
             .getService();
 final DatabaseClient client = spanner.getDatabaseClient(databaseId);
כדי לקבל רק יומני אזהרות, משתמשים ב-setWarnIfInactiveTransactions.
 final SessionPoolOptions sessionPoolOptions = SessionPoolOptions.newBuilder().setWarnIfInactiveTransactions().build()

 final Spanner spanner =
         SpannerOptions.newBuilder()
             .setSessionPoolOption(sessionPoolOptions)
             .build()
             .getService();
 final DatabaseClient client = spanner.getDatabaseClient(databaseId);
המשך
כדי לקבל יומני אזהרות ולהסיר טרנזקציות לא פעילות, משתמשים ב-SessionPoolConfig עם InactiveTransactionRemovalOptions.
 client, err := spanner.NewClientWithConfig(
     ctx, database, spanner.ClientConfig{SessionPoolConfig: spanner.SessionPoolConfig{
         InactiveTransactionRemovalOptions: spanner.InactiveTransactionRemovalOptions{
         ActionOnInactiveTransaction: spanner.WarnAndClose,
         }
     }},
 )
 if err != nil {
     return err
 }
 defer client.Close()
כדי לקבל רק יומני אזהרות, משתמשים ב-customLogger.
 customLogger := log.New(os.Stdout, "spanner-client: ", log.Lshortfile)
 // Create a logger instance using the golang log package
 cfg := spanner.ClientConfig{
         Logger: customLogger,
     }
 client, err := spanner.NewClientWithConfig(ctx, db, cfg)
סשנים מרובי-ערוצים
סשנים מרובי-ערוצים מאפשרים ליצור מספר גדול של בקשות מקבילות בסשן אחד. סשן מרובה-ערוצים הוא מזהה שמשמש בכמה ערוצי gRPC. הוא לא יוצר צווארי בקבוק נוספים. לסשנים מרובי-ערוצים יש את היתרונות הבאים:
- צריכת משאבים מופחתת בקצה העורפי בזכות פרוטוקול פשוט יותר לניהול סשנים. לדוגמה, הם נמנעים מפעילויות תחזוקה של סשנים שקשורות לתחזוקת הבעלות על הסשן ולאיסוף.
- סשן ארוך שלא דורש בקשות keep-alive כשהוא לא פעיל.
יש תמיכה בסשנים מרובים במקרים הבאים:
- ספריות הלקוח של C++, Go, Java, Node.js, PHP, Python, Ruby ו-Rust.
כלים בסביבה העסקית של Spanner שתלויים בספריות הלקוח שצוינו, כמו PGAdapter, JDBC, Hibernate, מנהל ההתקן database/sql, מנהל ההתקן dbAPI ו-GORM.
כלים בסביבה העסקית של Spanner שתלויים בספריות הלקוח של Java ו-Go, כמו PGAdapter, JDBC, Hibernate, database או sql driver ו-GORM. אתם יכולים להשתמש במדדי OpenTelemetry כדי לראות איך התנועה מפוצלת בין מאגר הסשנים הקיים לבין הסשן המרובה. ב-OpenTelemetry יש מסנן מדדים,
is_multiplexed, שמציג סשנים מרובי-ערוצים כשהוא מוגדר לערךtrue.
יש תמיכה בסשנים מרובים בכל סוגי הטרנזקציות.
ספריות הלקוח מחליפות סשנים מרובי-ערוצים כל 7 ימים כדי למנוע שליחת טרנזקציות בסשנים לא פעילים.
בחלק מספריות הלקוח, סשנים מרובי-ערוצים מופעלים כברירת מחדל. באחרים, צריך להשתמש במשתני סביבה כדי להפעיל אותם. לפרטים נוספים, ראו הפעלת סשנים מרובים.
לתשומת ליבכם
אם אתם מנסים לבצע טרנזקציית קריאה או כתיבה עם גוף ריק, או טרנזקציה שבה כל שאילתה או פקודת DML נכשלה, יש כמה תרחישים שצריך להביא בחשבון בסשנים מרובי-ערוצים. בסשנים מרובי-ערוצים, צריך לכלול בכל בקשת commit אסימון pre-commit שנוצר על ידי השרת. בעסקאות שמכילות שאילתות או DML, חייבת להיות לפחות עסקה אחת קודמת של שאילתה או DML שהצליחה, כדי שהשרת ישלח בחזרה אסימון תקין לספריית הלקוח. אם לא היו שאילתות או טרנזקציות DML שהצליחו, ספריית הלקוח מוסיפה באופן משתמע את SELECT 1 לפני commit.
בעסקת קריאה או כתיבה בסשן מרובה, שיש בו רק מוטציות, אם אחת מהמוטציות היא לטבלה או לעמודה שלא קיימת בסכימה, הלקוח יכול להחזיר שגיאת INVALID_ARGUMENT במקום שגיאת NOT_FOUND.
הפעלת סשנים מרובי-ערוצים
סשנים מרובי-ערוצים מופעלים כברירת מחדל בספריות הלקוח הבאות:
- C++ בגרסה 2.41.0 ואילך.
- Go בגרסה 1.85.0 ואילך.
- Java בגרסה 6.98.0 ואילך.
- Node.js בגרסה 8.3.0 ואילך.
- PHP בגרסה 2.0.0 ואילך.
- Python בגרסה 3.57.0 ואילך.
- Ruby בגרסה 2.30.0 ואילך.
כדי להשתמש בסשנים מרובי-ערוצים בגרסאות קודמות של ספריות הלקוח של Node.js, Java ו-Go, צריך קודם להגדיר משתנה סביבה כדי להפעיל אותם.
כדי להפעיל סשנים מרובי-ערוצים, מגדירים את משתנה הסביבה GOOGLE_CLOUD_SPANNER_MULTIPLEXED_SESSIONS לערך TRUE. הדגל הזה גם מפעיל את התמיכה בסשנים מרובים לעסקאות ב-ReadOnly.
export GOOGLE_CLOUD_SPANNER_MULTIPLEXED_SESSIONS=TRUE
כדי להפעיל תמיכה בפעולות מחולקות למחיצות בסשנים מרובים, מגדירים את משתנה הסביבה GOOGLE_CLOUD_SPANNER_MULTIPLEXED_SESSIONS_PARTITIONED_OPS לערך TRUE.
export GOOGLE_CLOUD_SPANNER_MULTIPLEXED_SESSIONS_PARTITIONED_OPS=TRUE
כדי להפעיל תמיכה בעסקאות קריאה-כתיבה בסשנים מרובים, מגדירים את משתנה הסביבה GOOGLE_CLOUD_SPANNER_MULTIPLEXED_SESSIONS_FOR_RW ל-TRUE.
export GOOGLE_CLOUD_SPANNER_MULTIPLEXED_SESSIONS_FOR_RW=True
כדי לתמוך בטרנזקציה בסשן מרובה, צריך להגדיר את GOOGLE_CLOUD_SPANNER_MULTIPLEXED_SESSIONS לערך TRUE.
צפייה בתנועה של סשנים רגילים וסשנים מרובי-ערוצים
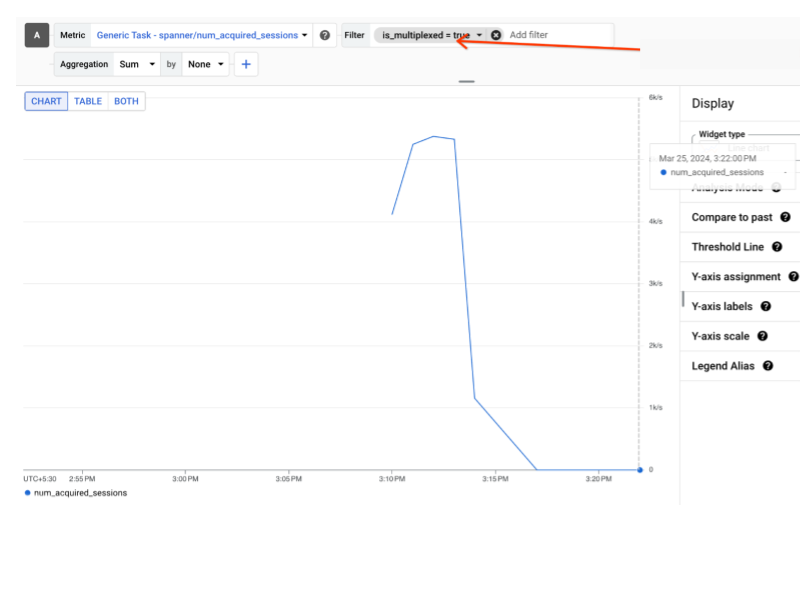
OpenTelemetry כולל את המסנן is_multiplexed כדי להציג תנועה של סשנים מרובי-ערוצים. כדי לראות סשנים מרובי-משתמשים, מגדירים את המסנן הזה לערך true. כדי לראות סשנים רגילים, מגדירים אותו לערך false.
- מגדירים את OpenTelemetry ל-Spanner לפי ההוראות בקטע לפני שמתחילים במאמר Spanner OpenTelemetry.
עוברים אל Metrics Explorer.
בתפריט הנפתח Metric, מסננים לפי
generic.לוחצים על Generic Task ועוברים אל Spanner > Spanner/num_acquired_sessions.
בשדה סינון, בוחרים מבין האפשרויות הבאות:
א.
is_multiplexed = falseכדי לראות את הסשנים הרגילים. ב. is_multiplexed = trueכדי לצפות בסשנים מרובי-ערוצים.בתמונה הבאה מוצגת האפשרות Filter עם בחירה בסשנים מרובי-ערוצים.
למידע נוסף על השימוש ב-OpenTelemetry עם Spanner, קראו את המאמרים Leveraging OpenTelemetry to democratize Spanner Observability ו-Examine latency in a Spanner component with OpenTelemetry.
פתרון בעיות
שגיאות נפוצות שקשורות לסשן שהאפליקציה שלכם עלולה להיתקל בהן:
Session not foundRESOURCE_EXHAUSTED
מידע נוסף זמין במאמר שגיאות בסשן.