


本文档介绍了可用于监控 Managed Service for Apache Spark 批量工作负载并排查其问题的工具和文件。
通过 Google Cloud 控制台排查工作负载问题
当批量作业失败或性能不佳时,建议您先打开其作业详情(批处理详情)页面,方法是在 Google Cloud 控制台的作业页面的无服务器 Spark 标签页上点击批量任务 ID。
使用“摘要”标签页:您的问题排查中心
摘要标签页会在批处理作业详情页面打开时默认处于选中状态,其中会显示关键指标和经过滤的日志,可帮助您快速对批处理作业的运行状况进行初步评估。完成初步评估后,您可以使用批处理作业详情页面中提供的更专业的工具(例如 Spark 界面、Logs Explorer 和 Gemini Cloud Assist)进行更深入的分析。
批量指标重要信息
批处理作业详情页面上的摘要和监控标签页包含显示重要批处理工作负载指标值的图表。指标图表会在作业完成后填充,并直观地显示潜在问题,例如资源争用、数据倾斜或内存压力。

下表列出了 Google Cloud 控制台中的批处理作业详情页面上显示的 Spark 工作负载指标,并介绍了指标值如何提供对工作负载状态和性能的分析洞见。
| 指标 | 它显示了什么? |
|---|---|
| 执行器级指标 | |
| JVM GC 时间与运行时间的比率 | 此指标显示每个执行器的 JVM GC(垃圾回收)时间与运行时的比率。比率较高可能表示在特定执行器上运行的任务中存在内存泄漏,或数据结构效率低下,这可能会导致对象流失率较高。 |
| 溢出到磁盘的字节数 | 此指标显示了不同执行程序中溢出的磁盘字节总数。如果执行器显示较高的溢出磁盘字节数,则可能表示数据倾斜。如果此指标随时间推移而增加,则可能表示存在内存压力或内存泄漏的阶段。 |
| 读取和写入的字节数 | 此指标显示每个执行器写入的字节数与读取的字节数。读取或写入的字节数存在较大差异可能表明,复制联接导致特定执行器上的数据放大。 |
| 读取和写入的记录数 | 此指标显示每个执行器读取和写入的记录数。如果读取的记录数较多,而写入的记录数较少,则可能表示特定执行器上的处理逻辑存在瓶颈,导致记录在等待时被读取。如果执行器在读写方面持续滞后,则可能表明这些节点上存在资源争用,或者执行器特定代码效率低下。 |
| Shuffle 写入时间与运行时间的比率 | 该指标显示执行器在 shuffle 运行时花费的时间与总运行时相比所占的比例。如果某些执行器的此值较高,则可能表示数据倾斜或数据序列化效率低下。 您可以在 Spark 界面中识别 Shuffle 写入时间较长的阶段。在这些阶段中,查找完成时间超过平均时间的异常任务。检查具有高 shuffle 写入时间的执行器是否也显示高磁盘 I/O 活动。更高效的序列化和额外的分区步骤可能会有所帮助。如果记录写入量远大于记录读取量,则可能表明由于联接效率低下或转换不正确而导致了意外的数据重复。 |
| 应用级指标 | |
| 阶段进程 | 此指标显示处于失败、等待和运行阶段的阶段数。大量失败或等待阶段可能表示数据倾斜。使用 Spark 界面中的阶段标签页检查数据分区,并调试阶段失败的原因。 |
| Batch Spark 执行程序 | 此指标显示可能需要的执行器数量与正在运行的执行器数量。如果所需执行器数量与正在运行的执行器数量之间存在较大差异,则可能表示存在自动扩缩问题。 |
| 虚拟机级指标 | |
| 使用的内存 | 此指标显示正在使用的虚拟机内存百分比。如果主节点百分比很高,则可能表示驱动程序面临内存压力。对于其他虚拟机节点,百分比较高可能表示执行器内存不足,这可能会导致磁盘溢出率较高,并导致工作负载运行时较慢。使用 Spark 界面分析执行器,检查是否存在 GC 时间过长和任务失败率过高的问题。此外,还调试了 Spark 代码,以解决大型数据集缓存和不必要的变量广播问题。 |
作业日志
批量作业作业详情页面包含作业日志标签页(和日志要点),其中列出了从作业(批处理工作负载)日志中过滤出的警告和错误。借助此功能,您无需手动解析大量日志文件,即可快速识别关键问题。您可以从下拉菜单中选择日志严重级别(例如 Error),并添加文本过滤条件以缩小结果范围。如需执行更深入的分析,请点击在 Logs Explorer 中查看图标,以在 Logs Explorer 中打开所选批处理日志。

示例:在 Google Cloud 控制台的批量作业详情页面上,从“严重级别”选择器中选择 Errors 后,Logs Explorer 会打开。

Spark 界面
Spark 界面会从 Managed Service for Apache Spark 批量工作负载中收集 Apache Spark 执行详情。Spark 界面功能默认处于启用状态,不收取任何费用。
Spark 界面功能收集的数据会保留 90 天。您可以使用此网页界面监控和调试 Spark 工作负载,而无需创建永久性历史记录服务器。
所需的 Identity and Access Management 权限和角色
如需将 Spark 界面功能与批处理工作负载搭配使用,需要以下权限。
数据收集权限:
dataproc.batches.sparkApplicationWrite。必须向运行批处理工作负载的服务账号授予此权限。此权限包含在Managed Service for Apache Spark Worker角色中,该角色会自动授予 Managed Service for Apache Spark 默认使用的 Compute Engine 默认服务账号(请参阅 Managed Service for Apache Spark 服务账号)。但是,如果您为批处理工作负载指定自定义服务账号,则必须向该服务账号添加dataproc.batches.sparkApplicationWrite权限(通常通过向服务账号授予 Managed Service for Apache SparkWorker角色)。Spark 界面访问权限:
dataproc.batches.sparkApplicationRead。必须向用户授予此权限,用户才能在Google Cloud 控制台中访问 Spark 界面。Dataproc Viewer、Dataproc Editor和Dataproc Administrator角色包含此权限。如需在 Google Cloud 控制台中打开 Spark 界面,您必须拥有以下角色之一,或拥有包含此权限的自定义角色。
打开 Spark 界面
Spark 界面页面可在 Google Cloud 控制台批量工作负载中找到。
在 Google Cloud 控制台中,前往 Managed Service for Apache Spark 作业页面。
选择无服务器 Spark 标签页,然后点击批处理任务 ID 以打开其作业详情页面。
点击在 Spark 界面中查看(位于 Spark 应用 ID 旁边)或查看 Spark 界面。
在以下情况下,在 Spark 界面中查看链接处于停用状态:
Managed Service for Apache Spark 日志
Managed Service for Apache Spark 默认启用日志记录功能,并且工作负载日志会在工作负载完成后保留。Managed Service for Apache Spark 会在 Cloud Logging 中收集工作负载日志。您可以在 Logs Explorer 中的 Cloud Dataproc Batch 资源下访问 Managed Service for Apache Spark 日志。
在运行时 3.0 及更高版本上收集诊断信息
对于在运行时 3.0 及更高版本上运行的批处理工作负载,不支持使用 dataproc.diagnostics.enabled 属性自动收集诊断 tar 文件。此外,驱动程序日志会直接流式传输到 Cloud Logging,而不是 Cloud Storage 暂存存储桶。
如需收集诊断信息并排查运行时 3.0 及更高版本工作负载的问题,请使用以下工具:
- Cloud Logging 中的驱动程序和执行器日志:在日志浏览器中查询
Cloud Dataproc Batch资源 (cloud_dataproc_batch),以查找dataproc.googleapis.com/output和dataproc.googleapis.com/spark日志条目。如需了解详情,请参阅 Managed Service for Apache Spark 日志类型和示例查询。 - Managed Service for Apache Spark Spark 界面:直接从 Google Cloud 控制台中的批处理作业详情页面打开 Spark 界面,以检查阶段执行详情、任务指标、执行器资源消耗和时间轴事件,而无需 Persistent History Server (PHS)。
- Gemini Cloud Assist 调查:在批处理作业详情页面中使用 Gemini Cloud Assist,获取自动化的根本原因分析和问题排查建议。
查询 Managed Service for Apache Spark 日志
Google Cloud 控制台中的 Logs Explorer 提供了一个查询窗格,可帮助您构建查询来检查批量工作负载日志。您可以按照以下步骤构建查询,以检查批量工作负载日志:
- 系统会选择您当前的项目。您可以点击优化范围项目以选择其他项目。
定义批量日志查询。
使用过滤条件菜单过滤批处理工作负载。
在所有资源下,选择 Cloud Dataproc 批处理资源。

在选择资源面板中,选择批处理位置,然后选择批处理 ID。这些批处理参数列在 Google Cloud 控制台中 Managed Service for Apache Spark 作业页面的 Serverless Spark 标签页上。

点击应用。
在选择日志名称下,在搜索日志名称框中输入
dataproc.googleapis.com,以限制要查询的日志类型。选择一个或多个列出的日志文件名。
使用查询编辑器过滤特定于虚拟机的日志。
指定资源类型和虚拟机资源名称,如以下示例所示:
resource.type="cloud_dataproc_batch"
labels."dataproc.googleapis.com/resource_name"="VM_NAME_PREFIX-BATCH_UUID-VM_SUFFIX"
- VM_NAME_PREFIX:对于在 Managed Service for Apache Spark
3.0及更高版本运行时上运行的批量工作负载,请使用gdpic-rm;对于在更低版本运行时上运行的批量工作负载,请使用gdpic-srvls-batch。 - BATCH_UUID:批处理作业 UUID 列在 Google Cloud 控制台中的批处理作业详细信息(批处理详细信息)页面上,当您点击作业页面的无服务器 Spark 标签页上的批处理任务 ID 时,该页面会打开。

批处理日志还会在虚拟机资源名称中列出批处理 UUID。以下是批处理 driver.log 的示例:

- VM_NAME_PREFIX:对于在 Managed Service for Apache Spark
点击运行查询。
Managed Service for Apache Spark 日志类型和示例查询
以下列表介绍了不同的 Managed Service for Apache Spark 日志类型,并提供了每种日志类型的示例 Logs Explorer 查询。
dataproc.googleapis.com/output:此日志文件包含批量工作负载输出。Managed Service for Apache Spark 会将批处理输出流式传输到output命名空间,并将文件名设置为JOB_ID.driver.log。用于输出日志的 Logs Explorer 查询示例:
resource.type="cloud_dataproc_batch"
resource.labels.location="REGION"
resource.labels.batch_id="BATCH_ID"
logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Foutput"
dataproc.googleapis.com/spark:spark命名空间会汇总在 Managed Service for Apache Spark 集群主服务器和工作器虚拟机上运行的守护进程和执行器的 Spark 日志。每个日志条目都包含master、worker或executor组件标签,用于标识日志来源,如下所示:executor:来自用户代码执行器的日志。通常,这些是分布式日志。master:来自 Spark 独立资源管理器主节点的日志,类似于 Managed Service for Apache Spark YARNResourceManager日志。worker:来自 Spark 独立资源管理器工作器的日志,类似于 Managed Service for Apache Spark YARNNodeManager日志。
针对
spark命名空间中所有日志的 Logs Explorer 查询示例:resource.type="cloud_dataproc_batch" resource.labels.location="REGION" resource.labels.batch_id="BATCH_ID" logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fspark"
spark命名空间中 Spark 独立组件日志的 Logs Explorer 查询示例:resource.type="cloud_dataproc_batch" resource.labels.location="REGION" resource.labels.batch_id="BATCH_ID" logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fspark" jsonPayload.component="COMPONENT"
dataproc.googleapis.com/startup:startup命名空间包含批处理(集群)启动日志。包含所有初始化脚本日志。组件通过标签进行标识,例如:startup-script[855]: ... activate-component-spark[3050]: ... enable spark-worker
resource.type="cloud_dataproc_batch"
resource.labels.location="REGION"
resource.labels.batch_id="BATCH_ID"
logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fstartup"
labels."dataproc.googleapis.com/resource_name"="VM_NAME_PREFIX-BATCH_UUID-VM_SUFFIX"
dataproc.googleapis.com/agent:agent命名空间会汇总 Managed Service for Apache Spark 代理日志。每个日志条目都包含用于标识日志来源的文件名标签。针对由指定工作器虚拟机生成的代理日志的 Logs Explorer 查询示例:
resource.type="cloud_dataproc_batch"
resource.labels.location="REGION"
resource.labels.batch_id="BATCH_ID"
logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fagent"
labels."dataproc.googleapis.com/resource_name"="VM_NAME_PREFIX-BATCHUUID-wWORKER#"
dataproc.googleapis.com/autoscaler:autoscaler命名空间会汇总 Managed Service for Apache Spark 自动扩缩器日志。针对由指定工作器虚拟机生成的自动扩缩器日志的 Logs Explorer 查询示例:
resource.type="cloud_dataproc_batch"
resource.labels.location="REGION"
resource.labels.batch_id="BATCH_ID"
logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fautoscaler"
labels."dataproc.googleapis.com/resource_name"="VM_NAME_PREFIX-BATCHUUID-wWORKER#"
如需了解详情,请参阅 Managed Service for Apache Spark 日志。
如需了解 Managed Service for Apache Spark 审计日志,请参阅 Managed Service for Apache Spark 审计日志记录。
工作负载指标
Managed Service for Apache Spark 提供批量和 Spark 指标,您可以在 Google Cloud 控制台中的Metrics Explorer 或批量作业详情页面中查看这些指标。
批处理指标
Managed Service for Apache Spark batch 资源指标可让您深入了解批量资源,例如批量执行器的数量。批处理指标以 dataproc.googleapis.com/batch 为前缀。
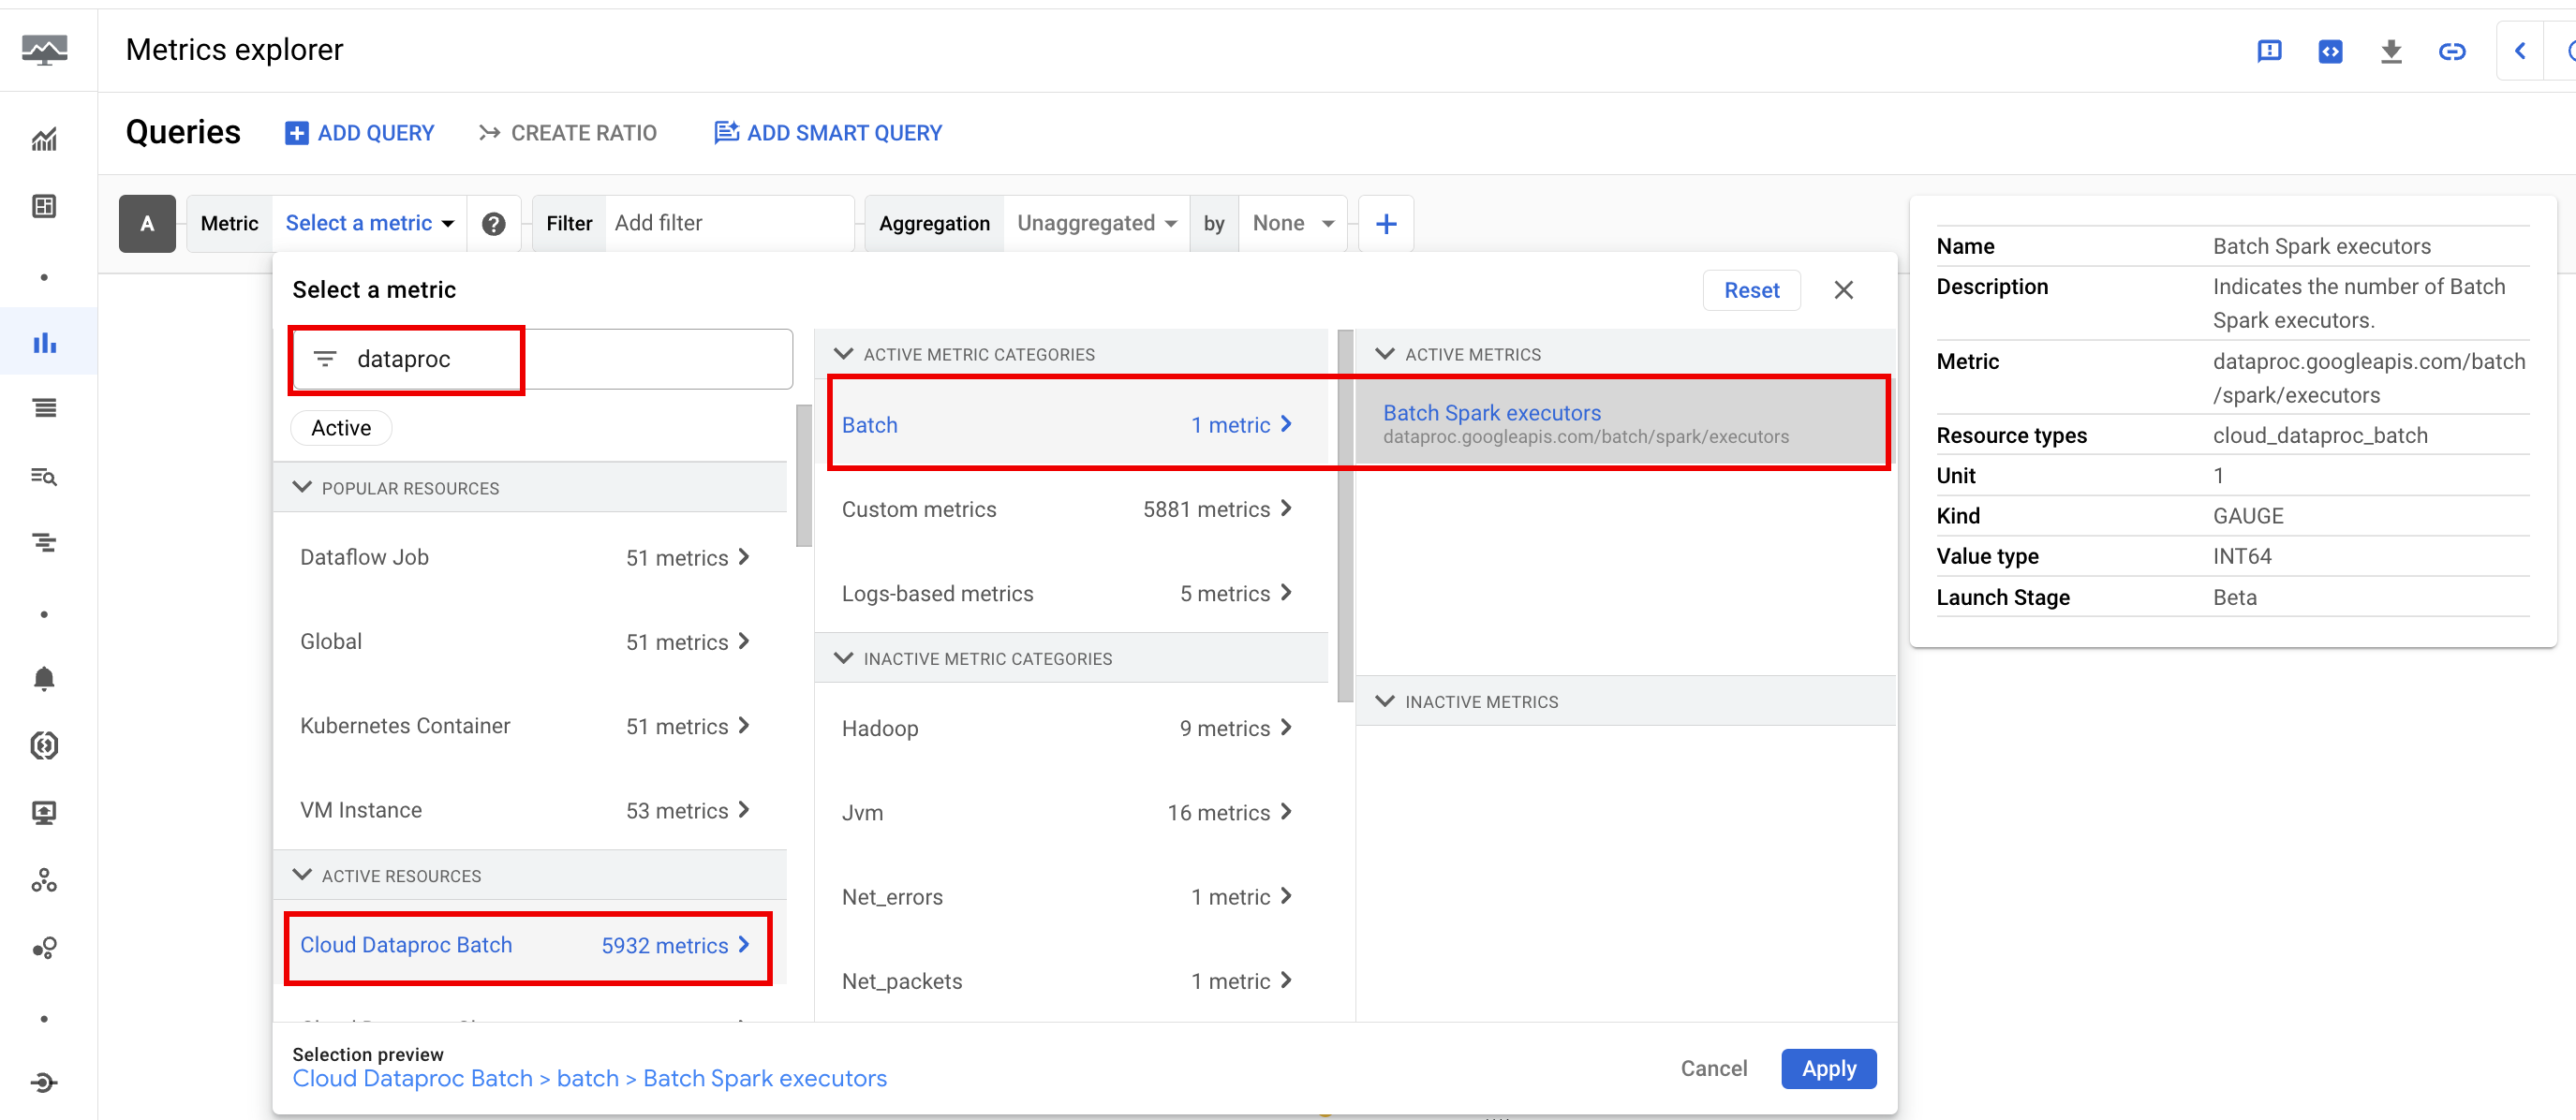
Spark 指标
默认情况下,Managed Service for Apache Spark 会启用可用 Spark 指标的收集,除非您使用 Spark 指标收集属性停用或替换一个或多个 Spark 指标的收集。
可用的 Spark 指标包括 Spark 驱动程序和执行器指标以及系统指标。可用的 Spark 指标带有 custom.googleapis.com/ 前缀。

设置指标提醒
您可以创建 Managed Service for Apache Spark 指标提醒,以便及时收到工作负载问题的通知。
创建图表
您可以使用Google Cloud 控制台中的 Metrics Explorer 创建图表,以直观呈现工作负载指标。例如,您可以创建一个图表来显示 disk:bytes_used,然后按 batch_id 进行过滤。
Cloud Monitoring
Monitoring 使用工作负载元数据和指标来提供有关 Managed Service for Apache Spark 工作负载的运行状况和性能的数据洞见。工作负载指标包括 Spark 指标、批处理指标和操作指标。
您可以在 Google Cloud 控制台中使用 Cloud Monitoring 来探索指标、添加图表、创建信息中心和创建提醒。
创建信息中心
您可以创建一个信息中心,使用来自多个项目和不同 Google Cloud 产品的指标来监控工作负载。如需了解详情,请参阅创建和管理自定义信息中心。
Persistent History Server
Managed Service for Apache Spark 会创建运行工作负载所需的计算资源,在这些资源上运行工作负载,然后在工作负载完成后删除这些资源。工作负载完成后,工作负载指标和事件不会保留。不过,您可以使用 Persistent History Server (PHS) 将工作负载应用历史记录(事件日志)保留在 Cloud Storage 中。
如需将 PHS 与批处理工作负载搭配使用,请执行以下操作:
创建 Managed Service for Apache Spark Persistent History Server (PHS)。
在提交工作负载时指定 PHS。
使用组件网关连接到 PHS,以查看应用详细信息、调度器阶段、任务级详细信息以及环境和执行器信息。
自动调节
- 为 Managed Service for Apache Spark 启用自动调节功能:您可以在使用 Google Cloud 控制台、gcloud CLI 或 Managed Service for Apache Spark API 提交每个周期性 Spark 批量工作负载时,为 Managed Service for Apache Spark 启用自动调节功能。
控制台
请执行以下步骤,为每个周期性 Spark 批处理工作负载启用自动调节:
在 Google Cloud 控制台中,前往 Managed Service for Apache Spark 作业页面。
如需创建批处理工作负载,请点击提交作业以打开提交作业页面。
在为作业选择计算类型下,确认已选择无服务器 Spark。
在无服务器作业详情部分中:
- 指定任务 ID 或接受默认 ID。
- 选择运行时配置文件(或保留您所在区域的默认服务配置),然后点击摘要卡片中的配置(或点击运行时配置文件菜单中的创建新配置文件),打开运行时配置文件配置面板。
- 在运行时配置文件配置面板中,展开其他配置,然后点击其他自定义旁边的修改。
- 在其他自定义面板中的自动调节下,点击启用切换开关,然后填写同类群组 ID,该 ID 用于将批处理标识为一系列周期性工作负载之一。Gemini 辅助分析会应用于使用此同类群组 ID 提交的第二个及后续工作负载。例如,为运行每日 TPC-H 查询的计划工作负载指定
tpch-query1作为同类群组 ID。 - 在其他自定义面板中点击保存,然后在运行时配置文件配置面板中点击使用配置(或保存新配置文件)。
根据需要在提交作业页面上填写文件和工件以及作业执行和属性部分,然后点击提交。如需了解详情,请参阅提交批处理工作负载。
gcloud
在终端窗口或 Cloud Shell 中本地运行以下 gcloud CLI gcloud dataproc batches submit 命令,以便为每个周期性 Spark 批处理工作负载启用自动调节功能:
gcloud dataproc batches submit COMMAND \
    --region=REGION \
    --cohort=COHORT \
    other arguments ...
替换以下内容:
- COMMAND:Spark 工作负载类型,例如
Spark、PySpark、Spark-Sql或Spark-R。 - REGION:工作负载在其中运行的区域。
- COHORT:同类群组名称,用于将批次标识为一系列周期性工作负载之一。Gemini 辅助分析会应用于使用此同类群组名称提交的第二个及后续工作负载。例如,对于运行每日 TPC-H 查询的计划工作负载,请指定
TPCH Query 1作为同类群组名称。
API
在 batches.create 请求中添加 RuntimeConfig.cohort 名称,以便在每个周期性 Spark 批处理工作负载上启用自动调节。自动调优会应用于使用此同类群组名称提交的第二个及后续工作负载。例如,对于运行每日 TPC-H 查询的预定工作负载,请指定 TPCH-Query1 作为同类群组名称。
示例:
...
runtimeConfig:
  cohort: TPCH-Query1
...