


Planifier un transfert Snowflake
Le connecteur Snowflake fourni par le service de transfert de données BigQuery vous permet de planifier et de gérer des jobs de transfert automatisés pour migrer des données de Snowflake vers BigQuery à l'aide de listes d'autorisation d'adresses IP publiques.
Présentation
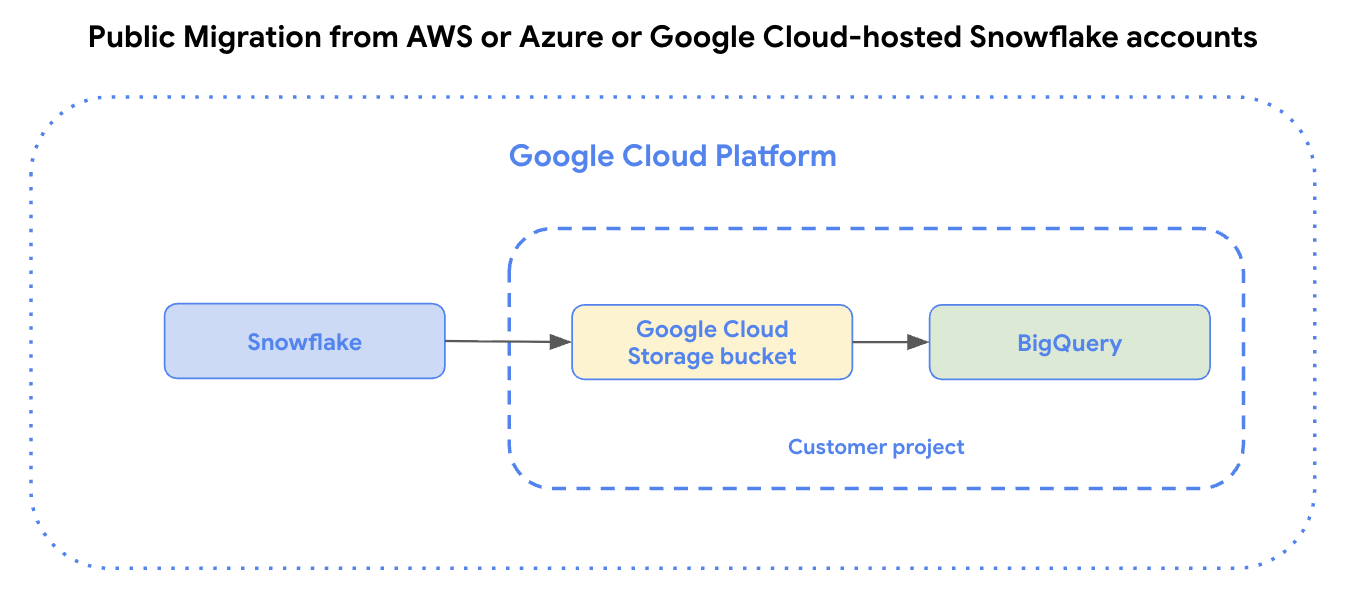
Le connecteur Snowflake engage les agents de migration dans Google Kubernetes Engine et déclenche une opération de chargement depuis Snowflake vers une zone de préproduction du bucket Cloud Storage.
- Pour les comptes Snowflake hébergés sur Amazon Web Services (AWS), Azure ou Google Cloud, les données sont d'abord transférées vers votre bucket Cloud Storage, puis vers BigQuery à l'aide du service de transfert de données BigQuery.
Le schéma suivant illustre les transferts de données publics à partir de comptes Snowflake hébergés sur Amazon Web Services (AWS) ou Azure, ou de comptes Snowflake hébergés sur Google Cloud.
Limites
Les transferts de données effectués à l'aide du connecteur Snowflake sont soumis aux limites suivantes :
- Le connecteur Snowflake n'accepte que les transferts à partir de tables d'une seule base de données et d'un seul schéma Snowflake. Pour transférer des données à partir de tables comportant plusieurs bases de données ou schémas Snowflake, vous pouvez configurer chaque job de transfert séparément.
- La vitesse de chargement des données de Snowflake vers votre bucket Amazon S3, votre conteneur Azure Blob Storage ou votre bucket Cloud Storage est limitée par l'entrepôt Snowflake que vous avez choisi pour ce transfert.
- BigQuery écrit les données de Snowflake dans Cloud Storage sous forme de fichiers Parquet. Les fichiers Parquet ne sont pas compatibles avec les types de données
TIMESTAMP_TZetTIMESTAMP_LTZ. Si vos données contiennent ces types, vous pouvez les exporter vers Amazon S3 sous forme de fichiers CSV, puis importer les fichiers CSV dans BigQuery. Pour en savoir plus, consultez Présentation des transferts de données Amazon S3.
Avant de commencer
Les sections suivantes décrivent les étapes à suivre pour configurer un transfert Snowflake.
Préparer votre projet Google Cloud
Pour créer et configurer votre projet Google Cloud pour un transfert Snowflake, procédez comme suit :
Créez un projet Google Cloud ou sélectionnez-en un existant.
Vérifiez que vous avez effectué toutes les actions requises pour activer le service de transfert de données BigQuery.
Créez un ensemble de données BigQuery pour stocker vos données. Vous n'avez pas besoin de créer de tables.
Obtenir les rôles IAM requis
Pour créer et gérer des transferts de données Snowflake, tous les comptes utilisateur et de service requis doivent disposer des rôles décrits dans le tableau suivant :
| Identité | Rôle | Ressource cible |
|---|---|---|
| Compte utilisateur | roles/bigquery.user |
ProjetGoogle Cloud |
| Compte utilisateur | roles/bigquery.dataOwner |
Ensemble de données BigQuery de destination |
| Compte utilisateur | roles/iam.serviceAccountUser |
Compte de service dédié |
| Compte de service dédié | roles/storage.objectViewer |
Bucket Cloud Storage de préproduction, et bucket(s) contenant les fichiers de mappage de schéma |
| Agent de service du service de transfert de données BigQuery | roles/storage.objectViewer |
Bucket Cloud Storage de préproduction |
| Agent de service du service de transfert de données BigQuery | roles/bigquery.dataEditor |
Ensemble de données BigQuery de destination |
| Agent de service du service de transfert de données BigQuery | roles/iam.serviceAccountTokenCreator |
Compte de service dédié, si vous utilisez un compte de service multiprojet |
| Compte de service Snowflake Google Cloud | roles/storage.objectUser |
Bucket Cloud Storage de préproduction |
| Compte de service Snowflake Google Cloud | roles/storage.bucketViewer |
Bucket Cloud Storage de préproduction |
Les sections suivantes fournissent plus d'informations sur les rôles et les autorisations requis pour chaque identité.
Obtenir les autorisations du compte utilisateur
Pour obtenir les autorisations nécessaires pour créer et gérer des configurations de transfert et exécuter des jobs avec un compte utilisateur, demandez à votre administrateur de vous accorder les rôles IAM suivants :
-
Créer et gérer des configurations de transfert et exécuter des jobs : Utilisateur BigQuery (
roles/bigquery.user) sur le projet -
Gérer et accorder l'accès à l'ensemble de données de destination : Propriétaire de données BigQuery (
roles/bigquery.dataOwner) sur l'ensemble de données BigQuery de destination -
Créer ou mettre à jour des configurations de transfert avec un compte de service dédié : Utilisateur du compte de service (
roles/iam.serviceAccountUser) sur le compte de service dédié
Pour en savoir plus sur l'attribution de rôles, consultez Gérer l'accès aux projets, aux dossiers et aux organisations.
Ces rôles prédéfinis contiennent les autorisations requises pour créer et gérer des configurations de transfert, et exécuter des jobs avec un compte utilisateur. Pour connaître les autorisations exactes requises, développez la section Autorisations requises :
Autorisations requises
Les autorisations suivantes sont requises pour créer et gérer des configurations de transfert, et exécuter des jobs avec un compte utilisateur :
-
bigquery.transfers.get -
bigquery.transfers.update -
bigquery.datasets.get -
bigquery.datasets.getIamPolicy -
bigquery.datasets.update -
bigquery.jobs.create -
bigquery.datasets.setIamPolicy -
iam.serviceAccounts.actAs
Vous pouvez également obtenir ces autorisations avec des rôles personnalisés ou d'autres rôles prédéfinis.
Obtenir des autorisations de compte de service dédié
Pour vous assurer que le compte de service dédié dispose des autorisations nécessaires pour utiliser un compte de service afin de lire les métadonnées de traduction, le schéma personnalisé ou les fichiers de préproduction lors de l'exécution du transfert, demandez à votre administrateur d'accorder le rôle IAM Lecteur des objets Storage (roles/storage.objectViewer) au compte de service dédié sur le bucket de préproduction Cloud Storage, ainsi que sur le ou les buckets contenant les fichiers de mappage de schéma.
Obtenir les autorisations de l'agent de service du service de transfert de données BigQuery
Pour vous assurer que l'agent de service du service de transfert de données BigQuery dispose des autorisations nécessaires pour utiliser un agent de service afin d'exécuter le transfert, demandez à votre administrateur d'accorder les rôles IAM suivants à l'agent de service du service de transfert de données BigQuery :
-
Lire les fichiers de données déchargés pendant l'exécution du transfert : Lecteur d'objets Storage (
roles/storage.objectViewer) sur le bucket de préproduction Cloud Storage -
Écrire les données transférées dans les tables de destination : Éditeur de données BigQuery (
roles/bigquery.dataEditor) sur l'ensemble de données BigQuery de destination -
Autoriser les transferts qui utilisent un compte de service multiprojet : Créateur de jetons du compte de service (
roles/iam.serviceAccountTokenCreator) sur le compte de service dédié multiprojet
Si le compte de service dédié se trouve dans le même projet que celui où le service de transfert de données BigQuery est activé, Google accorde automatiquement l'autorisation iam.serviceAccounts.getAccessToken requise. Vous ne devez attribuer manuellement le rôle Créateur de jetons de compte de service (roles/iam.serviceAccountTokenCreator) que si le compte de service dédié se trouve dans un autre projet. Pour en savoir plus, consultez Autorisation de compte de service multiprojet.
Obtenir les autorisations du compte de service Snowflake Google Cloud
Pour vous assurer que le compte de service Snowflake Google Cloud dispose des autorisations nécessaires pour écrire et gérer les fichiers de données déchargés dans le bucket de préproduction, demandez à votre administrateur d'accorder les rôles IAM suivants au compte de service Snowflake Google Cloud sur le bucket de préproduction Cloud Storage :
- Utilisateur d'objets Storage (
roles/storage.objectUser) - Lecteur de buckets Storage (
roles/storage.bucketViewer)
Ces rôles prédéfinis contiennent les autorisations requises pour écrire et gérer des fichiers de données déchargés dans le bucket de préproduction. Pour connaître les autorisations exactes requises, développez la section Autorisations requises :
Autorisations requises
Les autorisations suivantes sont requises pour écrire et gérer des fichiers de données déchargés dans le bucket de préproduction :
-
storage.buckets.get -
storage.objects.get -
storage.objects.create -
storage.objects.delete -
storage.objects.list
Préparer le bucket de préproduction
Pour préparer un transfert de données Snowflake, créez un bucket de préproduction, puis configurez-le pour autoriser l'accès en écriture depuis Snowflake. Vous devez d'abord transférer les données Snowflake dans un bucket Cloud Storage avant de pouvoir les charger dans BigQuery. La fonctionnalité d'espace de noms hiérarchique ne doit pas être activée sur le bucket de préproduction.
Pour créer et configurer un bucket de préproduction, procédez comme suit :
- Créez un bucket Cloud Storage.
Créez et configurez un objet d'intégration de stockage Snowflake pour permettre à Snowflake d'écrire des données dans le bucket Cloud Storage en tant qu'étape externe.
CREATE STORAGE INTEGRATION STORAGE_INTEGRATION_NAME
TYPE = EXTERNAL_STAGE
STORAGE_PROVIDER = 'GCS'
ENABLED = TRUE
STORAGE_ALLOWED_LOCATIONS = ('gcs://STAGING_BUCKET_NAME/');

-- Describe integration to retrieve Snowflake Google Cloud service account
DESCRIBE INTEGRATION STORAGE_INTEGRATION_NAME;
Remplacez les éléments suivants :
STORAGE_INTEGRATION_NAME: nom du nouvel objet d'intégration de stockage.STAGING_BUCKET_NAME: nom du bucket Cloud Storage que vous avez créé.
Lorsque vous exécutez la commande
DESCRIBE INTEGRATION, le compte de service Cloud Storage est listé sous le champSTORAGE_GCP_SERVICE_ACCOUNT. Accordez au compte de service Cloud Storage les autorisations suivantes sur le bucket Cloud Storage :storage.buckets.getstorage.objects.createstorage.objects.deletestorage.objects.getstorage.objects.list
Pour autoriser l'accès au bucket de préproduction, attribuez le rôle
roles/storage.objectViewerà l'agent de service du service de transfert de données BigQuery :gcloud storage buckets add-iam-policy-binding gs://STAGING_BUCKET_NAME \ --member=serviceAccount:service-PROJECT_NUMBER@gcp-sa-bigquerydatatransfer.iam.gserviceaccount.com \ --role=roles/storage.objectViewer
Pour un transfert de données privé Snowflake, créez le bucket de préproduction et configurez-le pour la connectivité privée.
Si votre organisation Google Cloud applique le partage limité au domaine avec la contrainte constraints/iam.allowedPolicyMemberDomains, l'attribution de rôles IAM sur le bucket de préproduction au compte de service STORAGE_GCP_SERVICE_ACCOUNT échoue, car ce compte de service appartient à l'organisation externe de Snowflake.
Vous ne pouvez pas déduire l'ID client Google Workspace de Snowflake à partir de l'adresse e-mail du compte de service. Obtenez le numéro client de l'une des manières suivantes :
- Si votre compte Snowflake est hébergé sur Google Cloud, exécutez
SELECT SYSTEM$GET_SNOWFLAKE_PLATFORM_INFO();dans Snowflake avec le rôleACCOUNTADMIN, puis recherchez la valeursnowflake-customer-directory-iddans le résultat. - Si votre compte Snowflake est hébergé sur AWS ou Azure, contactez l'assistance Snowflake pour demander l'ID client Google Workspace de votre compte de service
STORAGE_GCP_SERVICE_ACCOUNT.
Pour ajouter l'ID client de Snowflake à la liste d'autorisation de votre projet, mettez à jour la règle d'administration :
gcloud resource-manager org-policies allow \
    iam.allowedPolicyMemberDomains EXTERNAL_CUSTOMER_ID \
    --project=PROJECT_ID
Remplacez les éléments suivants :
EXTERNAL_CUSTOMER_ID: ID client Google Workspace de Snowflake.PROJECT_ID: ID du projet Google Cloud contenant votre bucket de préproduction.
Pour en savoir plus, consultez Restreindre les identités avec le partage limité au domaine.
Créer un utilisateur Snowflake avec les autorisations requises
Lors d'un transfert Snowflake, le connecteur Snowflake se connecte à votre compte Snowflake à l'aide d'une connexion JDBC. Vous devez créer un utilisateur Snowflake avec un rôle personnalisé qui ne dispose que des droits nécessaires pour effectuer le transfert de données.
Le tableau suivant répertorie les rôles et les droits requis pour le rôle personnalisé nommé MIGRATION_ROLE :
| Identité | Rôle ou droit | Ressource cible | Objectif |
|---|---|---|---|
| Utilisateur de migration | MIGRATION_ROLE |
Compte Snowflake | S'authentifier à l'aide d'une paire de clés RSA et exécuter des opérations de migration |
| Rôle de migration | USAGE |
Entrepôt Snowflake | Fournir une capacité de calcul pour l'exécution des requêtes. |
USAGE |
Base de données et schéma Snowflake | Accédez à la base de données et au schéma contenant les tables sources. | |
SELECT |
Tables sources | Lire les métadonnées de table et extraire les données pour le transfert. | |
USAGE |
Intégration du stockage | Autorisez le déchargement des données dans le bucket de préproduction Cloud Storage externe. |
Pour créer et configurer le rôle personnalisé et l'utilisateur de migration, exécutez les commandes SQL suivantes dans votre compte Snowflake :
Créez le rôle personnalisé
MIGRATION_ROLE:CREATE ROLE MIGRATION_ROLE;
Remplacez
MIGRATION_ROLEpar le nom du rôle personnalisé que vous créez.Accordez les autorisations requises au rôle personnalisé :
GRANT USAGE ON WAREHOUSE WAREHOUSE_NAME TO ROLE MIGRATION_ROLE;
GRANT USAGE ON DATABASE DATABASE_NAME TO ROLE MIGRATION_ROLE;
GRANT USAGE ON SCHEMA DATABASE_NAME.SCHEMA_NAME TO ROLE MIGRATION_ROLE;
GRANT SELECT ON ALL TABLES IN SCHEMA DATABASE_NAME.SCHEMA_NAME TO ROLE MIGRATION_ROLE;
GRANT USAGE ON INTEGRATION STORAGE_INTEGRATION_OBJECT_NAME TO ROLE MIGRATION_ROLE;
Remplacez les éléments suivants :
WAREHOUSE_NAME: nom de votre entrepôt de données.DATABASE_NAME: nom de votre base de données Snowflake.SCHEMA_NAME: nom de votre schéma Snowflake.STORAGE_INTEGRATION_OBJECT_NAME: nom de votre objet d'intégration de stockage Snowflake.
Créez l'utilisateur de migration en tant qu'utilisateur de service :
CREATE USER MIGRATION_USER TYPE = SERVICE;
Remplacez
MIGRATION_USERpar le nom de l'utilisateur de migration. La définition deTYPE = SERVICEcrée un utilisateur de service qui s'authentifie avec une paire de clés et est exempté de l'authentification multifacteur (MFA) interactive.Attribuez le rôle personnalisé à l'utilisateur de migration :
GRANT ROLE MIGRATION_ROLE TO USER MIGRATION_USER;
ALTER USER MIGRATION_USER SET DEFAULT_ROLE = MIGRATION_ROLE;
Générer une paire de clés pour l'authentification
En raison de l'abandon des connexions par mot de passe à facteur unique par Snowflake, nous vous recommandons d'utiliser une paire de clés pour l'authentification. Configurez une paire de clés en procédant comme suit :
Générez une clé privée PKCS#8 de 2 048 bits au format PEM. Choisissez de générer une clé privée non chiffrée ou chiffrée :
Pour générer une clé privée non chiffrée, exécutez la commande suivante :
openssl genrsa 2048 | openssl pkcs8 -topk8 -inform PEM -out rsa_key.p8 -nocrypt
Pour générer une clé privée chiffrée, exécutez la commande suivante et saisissez une phrase secrète lorsque vous y êtes invité :
openssl genrsa 2048 | openssl pkcs8 -topk8 -v2 des3 -inform PEM -out rsa_key.p8
Générez la clé publique correspondante :
openssl rsa -in rsa_key.p8 -pubout -out rsa_key.pub
Attribuez la clé publique, à l'exclusion de l'en-tête, du pied de page et des sauts de ligne, à votre utilisateur de migration Snowflake :
ALTER USER MIGRATION_USER SET RSA_PUBLIC_KEY='PUBLIC_KEY_STRING';
Remplacez
PUBLIC_KEY_STRINGpar le corps de la clé publique générée dans le fichierrsa_key.pub.
Pour en savoir plus, consultez Configurer l'authentification par paire de clés.
Autoriser le déchargement vers des emplacements externes intégrés
Le connecteur Snowflake décharge les données vers des emplacements externes intégrés pendant le transfert. Si votre compte Snowflake limite le déchargement vers des emplacements intégrés, le transfert échoue.
Pour autoriser le déchargement vers des emplacements intégrés, exécutez la commande SQL suivante dans votre compte Snowflake. Vous devez disposer du rôle ACCOUNTADMIN dans Snowflake pour exécuter cette commande.
ALTER ACCOUNT SET PREVENT_UNLOAD_TO_INLINE_URL = false;
Vous pouvez également utiliser SET pour autoriser le déchargement sur l'utilisateur de migration à l'aide de la commande suivante :
ALTER USER MIGRATION_USER SET PREVENT_UNLOAD_TO_INLINE_URL = false;
Remplacez MIGRATION_USER par le nom de l'utilisateur de migration.
Conditions préalables supplémentaires pour les configurations facultatives
Pour configurer des fonctionnalités facultatives pour votre transfert Snowflake, telles que la connectivité privée ou les transferts incrémentiels, vous devez remplir les conditions préalables décrites dans les sections suivantes.
Ajouter des règles de réseau
Pour la connectivité publique, le compte Snowflake autorise par défaut la connexion publique avec les identifiants de la base de données. Toutefois, vous avez peut-être configuré des règles ou des stratégies réseau qui pourraient empêcher le connecteur Snowflake de se connecter à votre compte. Dans ce cas, vous devez ajouter les adresses IP nécessaires à votre liste d'autorisation. Pour en savoir plus, consultez Configurer des règles de réseau pour les transferts Snowflake.
Détection et mappage de schémas
Pour définir votre schéma, vous pouvez utiliser le service de transfert de données BigQuery afin de détecter automatiquement le schéma et le mappage des types de données lors du transfert de données de Snowflake vers BigQuery. Vous pouvez également utiliser le moteur de traduction pour définir manuellement votre schéma et vos types de données.
Pour en savoir plus, consultez Détection et mappage de schémas pour Snowflake.
Activer les transferts incrémentiels
Pour configurer un transfert de données Snowflake incrémentiel, consultez Configurer des transferts incrémentiels pour Snowflake.
Activer la connectivité privée
Si vous souhaitez créer un transfert de données Snowflake privé, vous devez configurer votre réseau pour la connectivité privée.
Configurer un transfert Snowflake
Avant de configurer un transfert Snowflake, assurez-vous de disposer des informations suivantes :
- Identifiant de votre compte Snowflake, qui correspond au préfixe de l'URL de votre compte Snowflake. Par exemple,
ACCOUNT_IDENTIFIER.snowflakecomputing.com. - Le nom d'utilisateur et la clé privée associée disposant des autorisations appropriées pour votre base de données Snowflake. Il peut simplement disposer des autorisations requises pour exécuter le transfert de données.
- L'URI du bucket de préproduction à utiliser pour le transfert. Nous vous recommandons de définir une règle de cycle de vie pour ce bucket afin d'éviter des frais inutiles.
- URI du bucket Cloud Storage dans lequel vous avez stocké les fichiers de mappage de schéma obtenus à partir du moteur de traduction.
Pour créer une configuration de transfert Snowflake, procédez comme suit :
Console
Accédez à la page "Transferts de données" dans la console Google Cloud .
Cliquez sur Créer un transfert.
Dans la section Type de source, sélectionnez Migration Snowflake dans la liste Source.
Dans la section Transfer config name (Nom de la configuration de transfert), saisissez un nom pour le transfert, tel que
My migration, dans le champ Display name (Nom à afficher). Le nom à afficher peut être n'importe quelle valeur permettant d'identifier le transfert si vous devez le modifier par la suite.Dans la section Options de programmation, dans la liste Fréquence de répétition, sélectionnez une option pour spécifier la fréquence d'exécution de ce transfert de données. Pour personnaliser la fréquence de répétition, sélectionnez Personnalisée. Si vous sélectionnez À la demande, ce transfert s'exécute lorsque vous déclenchez manuellement le transfert.
Dans la section Destination settings (Paramètres de destination), choisissez l'ensemble de données que vous avez créé dans la liste Dataset (Ensemble de données).
Dans la section Snowflake Credentials (Identifiants Snowflake), procédez comme suit :
- Dans le champ Identifiant du compte, saisissez un identifiant unique pour votre compte Snowflake, qui combine le nom de votre organisation et le nom de votre compte. L'identifiant est le préfixe de l'URL du compte Snowflake, et non l'URL complète. Exemple :
ACCOUNT_IDENTIFIER.snowflakecomputing.com - Dans le champ Nom d'utilisateur, saisissez le nom de l'utilisateur Snowflake dont les identifiants et l'autorisation sont utilisés pour accéder à votre base de données afin de transférer les tables Snowflake. Nous vous recommandons d'utiliser l'utilisateur que vous avez créé pour ce transfert.
- Pour Mécanisme d'authentification, sélectionnez une méthode d'authentification des utilisateurs Snowflake :
MOT DE PASSE
- Dans le champ Mot de passe, saisissez le mot de passe de l'utilisateur Snowflake.
KEY_PAIR
- Dans le champ Clé privée, saisissez la clé privée associée à la clé publique associée à l'utilisateur Snowflake.
- Pour La clé privée est-elle chiffrée, sélectionnez ce champ si la clé privée est chiffrée avec une phrase secrète.
- Dans le champ Phrase secrète de la clé privée, saisissez la phrase secrète de la clé privée chiffrée. Ce champ est obligatoire si vous avez sélectionné Is Private Key Encrypted (La clé privée est-elle chiffrée ?). Pour en savoir plus, consultez Générer une paire de clés pour l'authentification.
- Dans le champ Entrepôt, saisissez un entrepôt utilisé pour l'exécution de ce transfert de données.
- Dans le champ Base de données Snowflake, saisissez le nom de la base de données Snowflake contenant les tables incluses dans ce transfert de données.
- Dans le champ Schéma Snowflake, saisissez le nom du schéma Snowflake contenant les tables incluses dans ce transfert de données.
- Dans le champ Identifiant du compte, saisissez un identifiant unique pour votre compte Snowflake, qui combine le nom de votre organisation et le nom de votre compte. L'identifiant est le préfixe de l'URL du compte Snowflake, et non l'URL complète. Exemple :
Dans la section Connectivité réseau, si vous créez un transfert de données privé, sélectionnez Utiliser un réseau privé, puis procédez comme suit :
- Dans le champ Rattachement de service PSC, saisissez l'URI du rattachement de service pour la connectivité privée à Snowflake. Pour en savoir plus, consultez Créer une configuration de transfert Snowflake privée.
- Pour Service de réseau privé, si votre compte Snowflake est hébergé sur AWS ou Azure, saisissez le lien auto du service d'annuaire pour votre équilibreur de charge réseau. Pour en savoir plus, consultez Créer une configuration de transfert Snowflake privée.
Dans la section Configuration du stockage, procédez comme suit :
- Dans le champ Nom de l'objet d'intégration de stockage, saisissez le nom de l'objet d'intégration de stockage Snowflake. Ce champ est obligatoire, sauf si vous spécifiez une zone de préparation externe Snowflake préconfigurée à l'aide de la commande
bq mkou de l'API pour créer la configuration de transfert. - Facultatif : Pour Taille maximale du fichier, spécifiez la taille maximale de chaque fichier déchargé de Snowflake vers l'emplacement de préproduction (en Mo).
Pour fournisseur de services cloud, sélectionnez
AWS,AZUREouGCPselon le fournisseur de services cloud qui héberge votre compte Snowflake.- Dans le champ URI GCS, saisissez l'URI du bucket Cloud Storage à utiliser comme bucket de préproduction.
- Dans le champ Nom de l'objet d'intégration de stockage, saisissez le nom de l'objet d'intégration de stockage Snowflake. Ce champ est obligatoire, sauf si vous spécifiez une zone de préparation externe Snowflake préconfigurée à l'aide de la commande
Dans la section Compte de service, procédez comme suit :
- Dans le champ Compte de service, saisissez un compte de service à utiliser avec ce transfert de données. Le compte de service doit appartenir au même projetGoogle Cloud que celui dans lequel la configuration de transfert et l'ensemble de données de destination sont créés. Le compte de service doit disposer des autorisations requises
storage.objects.listetstorage.objects.get.
- Dans le champ Compte de service, saisissez un compte de service à utiliser avec ce transfert de données. Le compte de service doit appartenir au même projetGoogle Cloud que celui dans lequel la configuration de transfert et l'ensemble de données de destination sont créés. Le compte de service doit disposer des autorisations requises
Dans la section Configuration du schéma, procédez comme suit :
- Pour Type d'ingestion, sélectionnez Complet ou Incrémentiel. Pour en savoir plus, consultez Configurer des transferts incrémentiels.
- Dans le champ Modèles de nom de table, spécifiez les tables à transférer en saisissant une liste de noms ou de modèles de table séparés par un point-virgule, par exemple
TABLE1_REGEX;TABLE2_REGEX. Les modèles doivent suivre la syntaxe d'expression régulière Java. Ce champ est obligatoire :lineitem;ordertbrenvoie les tables nomméeslineitemetordertb..*renvoie toutes les tables du schéma.
- Facultatif : Si vous souhaitez spécifier un chemin de sortie de traduction personnalisé, sélectionnez Utiliser la sortie du moteur de traduction BigQuery.
- Facultatif : Pour Chemin d'accès GCS de sortie de la traduction, spécifiez un chemin d'accès au dossier Cloud Storage contenant les fichiers de mappage de schéma du moteur de traduction. Vous pouvez laisser ce champ vide pour que le connecteur Snowflake détecte automatiquement votre schéma.
- Le chemin d'accès doit respecter le format
translation_target_base_uri/metadata/config/db/schema/et se terminer par/.
- Le chemin d'accès doit respecter le format
- Facultatif : Pour mapper les types
NUMBER(p, 0)Snowflake versINT64BigQuery, sélectionnez Mapper le type NUMBER Snowflake à échelle zéro vers le type INT64 BigQuery.
Facultatif : dans la section Options de notification, procédez comme suit :
- Cliquez sur le bouton pour activer les notifications par e-mail. Lorsque vous activez cette option, l'administrateur de transfert reçoit une notification par e-mail en cas d'échec de l'exécution du transfert.
- Pour le champ Select a Pub/Sub topic (Sélectionner un sujet Pub/Sub), choisissez le nom de votre sujet ou cliquez sur Create a topic (Créer un sujet). Cette option configure les notifications d'exécution Cloud Pub/Sub pour votre transfert.
Si vous utilisez des CMEK, dans la section Options avancées, sélectionnez Clé gérée par le client. La liste des CMEK disponibles s'affiche. Pour en savoir plus sur le fonctionnement des CMEK avec le Service de transfert de données BigQuery, consultez Spécifier une clé de chiffrement avec les transferts.
Cliquez sur Enregistrer.
La console Google Cloud affiche tous les détails de configuration du transfert, y compris un nom de ressource pour ce transfert.
bq
Saisissez la commande bq mk, puis spécifiez l'option --transfer_config. Le modèle suivant inclut des paramètres mutuellement exclusifs et conditionnels pour toutes les configurations compatibles. Lorsque vous exécutez la commande, n'incluez que les paramètres qui s'appliquent à votre mécanisme d'authentification, à votre mode de connectivité réseau, à votre emplacement de stockage de préproduction et à votre méthode de mappage de schéma.
bq mk \
  --transfer_config \
  --project_id=PROJECT_ID \
  --data_source=snowflake_migration \
  --target_dataset=DATASET_NAME \
  --display_name='DISPLAY_NAME' \
  --params='{
    "account_identifier": "ACCOUNT_IDENTIFIER",
    "username": "MIGRATION_USER",
    "auth_mechanism": "AUTH_MECHANISM",
    "password": "PASSWORD",
    "private_key": "PRIVATE_KEY_STRING",
    "is_private_key_encrypted": PRIVATE_KEY_ENCRYPTED,
    "private_key_passphrase": "PRIVATE_KEY_PASSPHRASE",
    "service_account": "SERVICE_ACCOUNT_EMAIL",
    "warehouse": "WAREHOUSE_NAME",
    "database": "DATABASE_NAME",
    "schema": "SCHEMA_NAME",
    "table_name_patterns": "TABLE_NAME_PATTERNS",
    "cloud_provider": "CLOUD_PROVIDER",
    "staging_gcs_uri": "STAGING_BUCKET_URI",
    "staging_s3_uri": "STAGING_S3_URI",
    "aws_access_key_id": "AWS_ACCESS_KEY_ID",
    "aws_secret_access_key": "AWS_SECRET_ACCESS_KEY",
    "azure_storage_account": "AZURE_STORAGE_ACCOUNT",
    "staging_azure_container": "STAGING_AZURE_CONTAINER",
    "azure_sas_token": "AZURE_SAS_TOKEN",
    "storage_integration_object_name": "STORAGE_INTEGRATION_NAME",
    "max_file_size_mb": MAX_FILE_SIZE_MB,
    "use_private_network": USE_PRIVATE_NETWORK,
    "service_attachment": "SERVICE_ATTACHMENT_URI",
    "private_network_service": "SERVICE_DIRECTORY_LINK",
    "ingestion_type": "INGESTION_TYPE",
    "specify_translation_output": SPECIFY_TRANSLATION_OUTPUT,
    "translation_output_gcs_path": "TRANSLATION_OUTPUT_GCS_PATH",
    "custom_schema_file_path": "CUSTOM_SCHEMA_PATH",
    "convert_number_to_int64": CONVERT_NUMBER_TO_INT64
  }'
Remplacez les éléments suivants :
PROJECT_ID: ID de votre projet Google Cloud . Si l'option--project_idn'est pas spécifiée, le projet par défaut est utilisé.DATASET_NAME: ensemble de données cible de BigQuery pour la configuration de transfert.DISPLAY_NAME: nom à afficher de la configuration de transfert. Le nom à afficher peut correspondre à n'importe quelle valeur permettant d'identifier le transfert si vous devez le modifier par la suite.
Configurez les paramètres --params applicables à votre configuration de transfert Snowflake :
| Détails du paramètre | |
|---|---|
ACCOUNT_IDENTIFIER |
Spécifiez un identifiant unique pour votre compte Snowflake, qui est une combinaison du nom de votre organisation et du nom de votre compte. L'identifiant est le préfixe de l'URL du compte Snowflake ( Par exemple, |
MIGRATION_USER |
Spécifiez le nom de l'utilisateur Snowflake dont les identifiants et l'autorisation sont utilisés pour accéder à votre base de données afin de transférer les tables Snowflake. Par exemple, |
AUTH_MECHANISM |
Spécifiez la méthode d'authentification des utilisateurs Snowflake.
Les valeurs acceptées sont |
PASSWORD |
Spécifiez le mot de passe de l'utilisateur Snowflake. N'incluez ce paramètre que si vous spécifiez |
PRIVATE_KEY_STRING |
Spécifiez la clé privée au format PKCS#8 PEM qui correspond à la clé publique attribuée à l'utilisateur Snowflake. N'incluez ce paramètre que si vous spécifiez Dans la chaîne JSON |
PRIVATE_KEY_ENCRYPTED |
Facultatif : Spécifiez |
PRIVATE_KEY_PASSPHRASE |
Spécifiez la phrase secrète de la clé privée chiffrée. N'incluez ce paramètre que si vous spécifiez |
SERVICE_ACCOUNT_EMAIL |
Spécifiez l'adresse e-mail du compte de service dédié à utiliser avec ce transfert de données, au format |
WAREHOUSE_NAME |
Spécifiez un entrepôt utilisé pour exécuter ce transfert de données. Par exemple, |
DATABASE_NAME |
Spécifiez le nom de la base de données Snowflake contenant les tables incluses dans ce transfert de données. Par exemple, |
SCHEMA_NAME |
Spécifiez le nom du schéma Snowflake contenant les tables incluses dans ce transfert de données. Par exemple, |
TABLE_NAME_PATTERNS |
Spécifiez les tables à transférer en saisissant une liste de noms de tables ou de modèles correspondant aux noms de tables du schéma, séparés par un point-virgule, par exemple
|
CLOUD_PROVIDER |
Spécifiez le fournisseur de services cloud qui héberge votre compte Snowflake. Les valeurs acceptées sont |
STAGING_BUCKET_URI |
Pour le paramètre Par exemple, |
STAGING_S3_URI |
Pour le paramètre Par exemple, |
AWS_ACCESS_KEY_ID |
Pour le paramètre |
AWS_SECRET_ACCESS_KEY |
Pour le paramètre |
AZURE_STORAGE_ACCOUNT |
Pour le paramètre |
STAGING_AZURE_CONTAINER |
Pour le paramètre |
AZURE_SAS_TOKEN |
Pour le paramètre |
STORAGE_INTEGRATION_NAME |
Spécifiez le nom de l'objet d'intégration de stockage Snowflake. Par exemple, |
MAX_FILE_SIZE_MB |
Facultatif : spécifiez la taille maximale, en Mo, de chaque fichier déchargé de Snowflake vers l'emplacement de préproduction. La valeur doit être comprise entre |
USE_PRIVATE_NETWORK |
Facultatif : si vous créez un transfert de données privé, définissez la valeur sur |
SERVICE_ATTACHMENT_URI |
Facultatif : Si vous créez un transfert de données privé, spécifiez l'URI du rattachement de service pour la connectivité privée à Snowflake. Pour en savoir plus, consultez Créer une configuration de transfert Snowflake privée. Par exemple :
|
SERVICE_DIRECTORY_LINK |
Facultatif : Si vous créez un transfert de données privé à partir d'un compte Snowflake hébergé sur Par exemple :
|
INGESTION_TYPE |
Spécifiez le mode d'ingestion pour le transfert. Les valeurs acceptées sont |
SPECIFY_TRANSLATION_OUTPUT |
Facultatif : Spécifiez |
TRANSLATION_OUTPUT_GCS_PATH |
Facultatif : spécifiez le chemin d'accès au dossier Cloud Storage contenant les fichiers de mappage de schéma du moteur de traduction. Ne définissez pas ce paramètre pour que le connecteur Snowflake détecte automatiquement votre schéma.
Par exemple :
|
CUSTOM_SCHEMA_PATH |
Facultatif : Si vous utilisez un schéma personnalisé, spécifiez le chemin d'accès au fichier de schéma personnalisé dans Cloud Storage. Par exemple :
|
CONVERT_NUMBER_TO_INT64 |
Facultatif : Spécifiez |
API
Utilisez la méthode projects.locations.transferConfigs.create et fournissez une instance de la ressource TransferConfig.
Configurer un transfert Snowflake pour le mappage de schéma
Le service de transfert de données BigQuery accepte trois méthodes de mappage de schéma pour les transferts Snowflake : la détection automatique de schéma, la sortie du moteur de traduction et le mappage manuel de schéma. Pour en savoir plus, consultez la documentation de référence sur la détection et le mappage de schémas.
Pour voir un exemple de configuration de transfert compatible avec chacune de ces méthodes de mappage de schéma, sélectionnez l'une des options suivantes :
Détection automatique
La référence de détection automatique de schéma mappe automatiquement les types de données Snowflake vers les types de données BigQuery équivalents sans nécessiter de métadonnées externes ni de fichiers de définition de schéma.
La commande suivante montre comment créer une configuration de transfert qui utilise la détection automatique de schéma :
bq mk \
  --transfer_config \
  --project_id=PROJECT_ID \
  --data_source=snowflake_migration \
  --target_dataset=DATASET_NAME \
  --display_name='Snowflake Auto Detection Transfer' \
  --params='{
    "account_identifier": "ACCOUNT_IDENTIFIER",
    "username": "MIGRATION_USER",
    "auth_mechanism": "KEY_PAIR",
    "private_key": "PRIVATE_KEY_STRING",
    "service_account": "SERVICE_ACCOUNT_EMAIL",
    "warehouse": "WAREHOUSE_NAME",
    "database": "DATABASE_NAME",
    "schema": "SCHEMA_NAME",
    "table_name_patterns": "orders;lineitem",
    "cloud_provider": "GCP",
    "staging_gcs_uri": "gs://STAGING_BUCKET_NAME/staging/",
    "storage_integration_object_name": "STORAGE_INTEGRATION_NAME",
    "ingestion_type": "Full"
  }'
Sortie de traduction
Utilise le mappage de métadonnées et de schéma généré par le traducteur SQL par lot de BigQuery pour gérer les mappages de tables et de types de données complexes. Pour en savoir plus, consultez Configuration du schéma de sortie de traduction.
La commande suivante montre comment créer une configuration de transfert qui utilise le résultat du moteur de traduction pour le mappage de schéma :
bq mk \
  --transfer_config \
  --project_id=PROJECT_ID \
  --data_source=snowflake_migration \
  --target_dataset=DATASET_NAME \
  --display_name='Snowflake Translation Output Transfer' \
  --params='{
    "account_identifier": "ACCOUNT_IDENTIFIER",
    "username": "MIGRATION_USER",
    "auth_mechanism": "KEY_PAIR",
    "private_key": "PRIVATE_KEY_STRING",
    "service_account": "SERVICE_ACCOUNT_EMAIL",
    "warehouse": "WAREHOUSE_NAME",
    "database": "DATABASE_NAME",
    "schema": "SCHEMA_NAME",
    "table_name_patterns": "orders;lineitem",
    "cloud_provider": "GCP",
    "staging_gcs_uri": "gs://STAGING_BUCKET_NAME/staging/",
    "storage_integration_object_name": "STORAGE_INTEGRATION_NAME",
    "ingestion_type": "Full",
    "specify_translation_output": true,
    "translation_output_gcs_path": "gs://TRANSLATION_BUCKET/output/metadata/config/DATABASE_NAME/SCHEMA_NAME/"
  }'
Schéma personnalisé
Fournissez un fichier de schéma JSON personnalisé dans Cloud Storage pour renommer des colonnes, personnaliser des types de données ou désigner des clés primaires.
La commande suivante montre comment créer une configuration de transfert qui utilise un schéma personnalisé pour le mappage de schéma :
bq mk \
  --transfer_config \
  --project_id=PROJECT_ID \
  --data_source=snowflake_migration \
  --target_dataset=DATASET_NAME \
  --display_name='Snowflake Custom Schema Transfer' \
  --params='{
    "account_identifier": "ACCOUNT_IDENTIFIER",
    "username": "MIGRATION_USER",
    "auth_mechanism": "KEY_PAIR",
    "private_key": "PRIVATE_KEY_STRING",
    "service_account": "SERVICE_ACCOUNT_EMAIL",
    "warehouse": "WAREHOUSE_NAME",
    "database": "DATABASE_NAME",
    "schema": "SCHEMA_NAME",
    "table_name_patterns": "orders;lineitem",
    "cloud_provider": "GCP",
    "staging_gcs_uri": "gs://STAGING_BUCKET_NAME/staging/",
    "storage_integration_object_name": "STORAGE_INTEGRATION_NAME",
    "ingestion_type": "Full",
    "custom_schema_file_path": "gs://CONFIG_BUCKET/schemas/custom_schema.json"
  }'
Spécifier une clé de chiffrement avec les transferts
Vous pouvez spécifier des clés de chiffrement gérées par le client (CMEK) pour chiffrer les données d'une exécution de transfert. Vous pouvez utiliser une clé CMEK pour accepter les transferts provenant de Snowflake.Lorsque vous spécifiez une clé CMEK avec un transfert, le service de transfert de données BigQuery l'applique à tous les caches sur disque intermédiaires des données ingérées afin que l'intégralité du workflow de transfert de données soit compatible avec CMEK.
Vous ne pouvez pas mettre à jour un transfert existant pour ajouter une clé CMEK si le transfert n'a pas été initialement créé avec une clé CMEK. Par exemple, vous ne pouvez pas modifier une table de destination initialement chiffrée par défaut pour être chiffrée avec des clés CMEK. À l'inverse, vous ne pouvez pas modifier une table de destination chiffrée par CMEK pour obtenir un type de chiffrement différent.
Vous pouvez mettre à jour une clé CMEK pour un transfert si la configuration de transfert a été initialement créée avec un chiffrement CMEK. Lorsque vous mettez à jour une clé CMEK pour une configuration de transfert, le service de transfert de données BigQuery propage cette clé aux tables de destination à la prochaine exécution du transfert, où le service de transfert de données BigQuery remplace toutes les clés CMEK obsolètes par la nouvelle clé lors de l'exécution du transfert. Pour en savoir plus, consultez Mettre à jour un transfert.
Vous pouvez également utiliser les clés par défaut d'un projet. Lorsque vous spécifiez une clé de projet par défaut avec un transfert, le service de transfert de données BigQuery utilise cette clé pour toutes les nouvelles configurations de transfert.
Quotas et limites
Par défaut, BigQuery a un quota de charge de 15 To par tâche de chargement et par table. En interne, Snowflake compresse les données de la table. La taille de la table exportée est donc supérieure à celle indiquée par Snowflake.
Pour améliorer les temps de chargement des tables plus volumineuses et supprimer la limite de chargement BigQuery de 15 To, spécifiez le type de job PIPELINE pour votre attribution de réservation.
En raison du modèle de cohérence d'Amazon S3, il est possible que certains fichiers ne soient pas inclus dans le transfert vers BigQuery.
Optimiser les performances de transfert de données
Vous pouvez surveiller les performances de vos transferts de données en consultant les journaux du transfert de données. Pour améliorer les performances de vos transferts de données, nous vous recommandons d'effectuer les étapes d'optimisation suivantes :
- Conservez votre instance Snowflake, votre bucket de préproduction et votre ensemble de données BigQuery dans la même région.
- Pour améliorer la vitesse de déchargement des tables, procédez comme suit :
- Augmentez la taille de votre entrepôt virtuel Snowflake, en particulier lorsque vous transférez des tables Snowflake volumineuses (1 Tio ou plus).
- Ajustez l'option
MAX_FILE_SIZEdans la configuration de transfert.- Des fichiers plus petits peuvent améliorer les vitesses de transfert, mais s'ils sont trop petits, ils peuvent être trop nombreux.
- Vous pouvez améliorer la vitesse de chargement des tables en augmentant le nombre de réservations d'emplacements BigQuery pour les types de jobs
PIPELINEetQUERY. - Lorsque vous effectuez un transfert complet, évitez le clustering et le partitionnement sur la table BigQuery de destination.
- Lorsque vous effectuez un transfert incrémentiel en mode Upsert, envisagez de mettre en cluster et de partitionner les colonnes de clé primaire pour améliorer les performances de transfert.
- Toutefois, évitez de mettre en cluster et de partitionner des colonnes de clé non primaire pour éviter de ralentir les opérations de fusion.
Tarifs
Pour en savoir plus sur les tarifs du service de transfert de données BigQuery, consultez la page Tarifs.
- Si l'entrepôt Snowflake et le bucket Amazon S3 se trouvent dans des régions différentes, Snowflake applique des frais de sortie lorsque vous exécutez un transfert de données Snowflake. Aucuns frais de sortie ne s'appliquent aux transferts de données Snowflake si l'entrepôt Snowflake et le bucket Amazon S3 se trouvent dans la même région.
- Lorsque des données sont transférées d'AWS vers Google Cloud, des frais de sortie intercloud sont appliqués.
Étapes suivantes
- Obtenez plus d'informations sur le Service de transfert de données BigQuery.
- Migrez du code SQL avec la traduction SQL par lot.