


בדף הזה מופיעה סקירה כללית על הגדרת הזמינות הגבוהה (HA) של מכונות Cloud SQL. כדי להגדיר מכונה חדשה לזמינות גבוהה, או כדי להפעיל זמינות גבוהה במכונה קיימת, קראו את המאמר הפעלה והשבתה של זמינות גבוהה במכונה.
סקירה כללית על הגדרת זמינות גבוהה (HA)
המטרה של הגדרת זמינות גבוהה היא לצמצם את זמן ההשבתה כשאזור או מכונה לא זמינים. זה יכול לקרות במהלך הפסקה זמנית בשירות באזור מסוים, או כשיש בעיה בחומרה. עם זמינות גבוהה, הנתונים שלכם ממשיכים להיות זמינים לאפליקציות הלקוח.
הגדרת הזמינות הגבוהה מספקת יתירות נתונים. מכונה של Cloud SQL שמוגדרת לזמינות גבוהה נקראת גם מכונה אזורית, ויש לה אזור ראשי ואזור משני בתוך האזור שהוגדר*. במכונה אזורית, ההגדרה מורכבת ממכונה ראשית וממכונה במצב המתנה. באמצעות רפליקציה סינכרונית ל-Persistent Disk של כל תחום (zone), כל פעולות הכתיבה שבוצעו במכונה הראשית משוכפלות לדיסקים בשני התחומים (zones) לפני שטרנזקציה מדווחת כטרנזקציה שבוצעה. במקרה של כשל במכונה או באזור, המכונה במצב המתנה הופכת למכונה הראשית החדשה. לאחר מכן המשתמשים מנותבים מחדש למכונה הראשית החדשה. התהליך הזה נקרא יתירות כשל.
אחרי מעבר לגיבוי בעת כשל, המכונה שקיבלה את המעבר לגיבוי בעת כשל ממשיכה להיות המכונה הראשית, גם אחרי שהמכונה המקורית חוזרת למצב אונליין. אחרי שהאזור או המכונה שבהם הייתה הפסקה זמנית בשירות יהיו זמינים שוב, המכונה הראשית המקורית תושמד ותיווצר מחדש. ואז היא הופכת למכונה החדשה במצב המתנה. אם בעתיד תתרחש יתירות כשל, המכונה הראשית החדשה תעבור למכונה המקורית באזור המקורי.
אם אתם צריכים שהמכונה הראשית תהיה באזור שבו הייתה ההפסקה, אתם יכולים לבצע חזרה למצב תקין. במעבר חזרה למצב תקין מתבצעים אותם שלבים כמו ביתירות כשל, רק בכיוון ההפוך, כדי לנתב מחדש את תעבורת הנתונים למכונה המקורית. כדי לבצע מעבר חזרה למצב תקין, פועלים לפי ההליך שמפורט בקטע הפעלת מעבר לגיבוי בעת כשל.
תמיכה ב-Persistent Disk אזורי להגדרת זמינות גבוהה ב-Cloud SQL, עם מעבד (CPU) ייעודי אחד לפחות, כוללת כיסוי מלא של הסכם רמת השירות (SLA). מכונה שהוגדרה לזמינות גבוהה עולה פי שניים ממכונה עצמאית. המחיר הזה כולל מעבד (CPU), זיכרון RAM ואחסון. למידע נוסף, תוכלו לעיין במחירון.
* למידע נוסף על שיקולים ספציפיים לאזור, קראו את המאמר מיקום גיאוגרפי ואזורים.
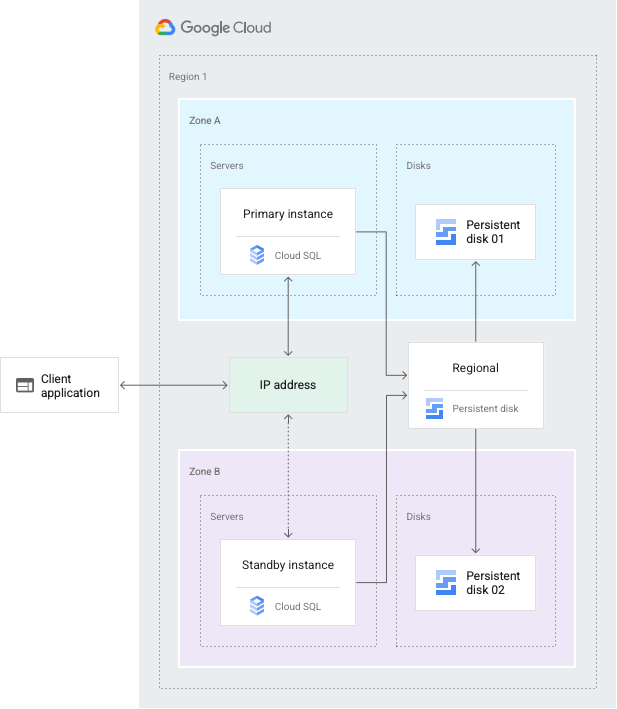
סקירה כללית על יתירות כשל
אם מכונה שהוגדרה לזמינות גבוהה מפסיקה להגיב, Cloud SQL עובר באופן אוטומטי להצגת נתונים מהמכונה במצב המתנה. כדי לבדוק אם התרחש מעבר לגיבוי בעת כשל, בודקים את היסטוריית המעברים לגיבוי בעת כשל ביומן הפעולות.
איך יוצרים שאילתות ב-Logs Explorer אם אתם צריכים מידע מפורט יותר על פעולה מסוימת, כמו המשתמש שביצע את הפעולה, אתם צריכים להפעיל את רישום הביקורת ביומן.
כדי לראות איך מעבר לגיבוי בעת כשל משפיע על המכונה, לוחצים על הכרטיסיות.
רגילה

יתירות כשל

אחרי יתירות כשל

חזרה למצב תקין (failback)
תהליך
זה מה שקורה:
המופע או האזור הראשיים נכשלים.
בכל שנייה, מערכת ה-heartbeat בודקת אם המכונה הראשית תקינה. אם לא מזוהים כמה אותות, מופעלת יתירות כשל.
המכונה במצב המתנה מציגה עכשיו נתונים אחרי החיבור מחדש.
באמצעות כתובת IP סטטית שמשותפת עם המכונה הראשית, המכונה במצב המתנה מציגה עכשיו נתונים מהאזור המשני.
דרישות
כדי ש-Cloud SQL יאפשר מעבר כשל, ההגדרה צריכה לעמוד בדרישות הבאות:
- המכונה הראשית צריכה להיות במצב פעולה רגיל (לא עצורה, לא בתחזוקה ולא מבצעת פעולה ארוכה במכונה של Cloud SQL, כמו פעולת גיבוי).
- האזור המשני והמכונה במצב המתנה צריכים להיות במצב תקין. כשהמכונה במצב המתנה לא מגיבה, פעולות של יתירות כשל נחסמות. אחרי ש-Cloud SQL מתקן את המכונה במצב המתנה והאזור המשני זמין, Cloud SQL מאפשר יתירות כשל.
גיבוי ושחזור
מומלץ מאוד להשתמש בגיבויים אוטומטיים כדי להבטיח זמינות גבוהה.
אפשרויות שחזור של מכונות עצמאיות
Cloud SQL לא משחזר באופן אוטומטי מכונות עצמאיות מהפסקה זמנית בפעילות באזור. כדי להעביר לאזור תקין מכונה שלא מוגדרת לזמינות גבוהה, צריך לשחזר באופן ידני את כל המכונות באזור. כדי לשחזר באופן ידני מכונה עצמאית מהפסקה זמנית בשירות באזור, אפשר להשתמש באחת מהאפשרויות הבאות:
מבצעים שחזור מערכת מנקודה מסוימת בזמן (PITR) במכונה למכונה חדשה שיוצרים. כדי להשתמש באפשרות הזו, צריך להפעיל את PITR במכונה האזורית לפני ההפסקה בפעילות באזור. יומני העסקאות של המכונה צריכים להיות מאוחסנים ב-Cloud Storage. אם יומני העסקאות מאוחסנים בדיסק, אתם יכולים להעביר אותם ל-Cloud Storage. כדי להשתמש באפשרות הזו, פועלים לפי השלבים שמפורטים בקטע ביצוע PITR במכונה לא זמינה.
אם למכונה יש רפליקה לקריאה בלבד באזור אחר, אתם יכולים לקדם את הרפליקה הזו כדי להחליף את המכונה העצמאית שמושפעת מההפסקה באזור. כדי להשתמש באפשרות הזו, פועלים לפי השלבים שמפורטים במאמר קידום רפליקה.
בשתי האפשרויות, צריך להתחשב בשיקולים הבאים:
יכול להיות שחלק מהעסקאות האחרונות שבוצעו במכונה הראשית לא יופיעו במכונה ששוחזרה. מרווח הזמן שבו עסקאות עלולות ללכת לאיבוד נקרא "יעד להתאוששות מאסון" (RPO).
- בשחזור PITR, ה-RPO הוא בדרך כלל חמש דקות או פחות.
- בקידום של עותק לקריאה בלבד, ה-RPO משתנה בהתאם לעומס העבודה של מסד הנתונים. למידע נוסף על מעקב אחרי השהיית הרפליקציה וצמצום שלה, קראו את המאמר השהיית רפליקציה.
אחרי שתבצעו את אחת מאפשרויות השחזור, תצטרכו להגדיר מחדש את כל הלקוחות של המכונות שמושפעות מההפסקה באזור, כי למכונות ששוחזרו יהיו כתובות IP ושמות חיבור שונים.
אפליקציות ומכונות
אין הבדל בעבודה עם מכונות ללא זמינות גבוהה ועם זמינות גבוהה, כך שאין צורך להגדיר את האפליקציה באופן מסוים. כשמתרחש מעבר לגיבוי בעת כשל, כל החיבורים הקיימים למכונה הראשית ולרפליקות לקריאה בלבד נסגרים, וייקח כ-60 שניות עד שהחיבורים למכונה הראשית ייווצרו מחדש. האפליקציה מתחברת מחדש באמצעות אותה מחרוזת חיבור או כתובת IP, כך שאין צורך לעדכן את האפליקציה אחרי יתירות כשל.
כדי לראות בדיוק איך האפליקציות מושפעות ממעבר לגיבוי בעת כשל, הפעילו ידנית את המעבר לגיבוי בעת כשל.
זמן השבתה לצורך תחזוקה
אירועי תחזוקה משפיעים על מכונות ראשיות שהוגדרו עם זמינות גבוהה באותו אופן שבו הם משפיעים על מכונות אחרות. המכונות הראשיות עשויות להיות מושבתות לזמן קצר. למידע נוסף על האופן שבו פעולות התחזוקה משפיעות על מכונות HA, ראו איך פועלת התחזוקה. כדי לצמצם את ההשפעה על השירות, אפשר לשנות את הגדרות התחזוקה כדי לקבוע מתי יתרחש זמן ההשבתה.
המאמרים הבאים
- הפעלה והשבתה של זמינות גבוהה במכונה.
- הפעלת יתירות כשל.
- מידע נוסף על ניהול החיבורים למסד הנתונים
- מידע נוסף על אזורים וזונים ב-Cloud SQL