


בדף הזה מתוארות שיטות לכוונון הביצועים של שאילתות ב-Spanner. לפני שמתחילים לכוונן את השאילתות, כדאי לעיין בדפים הבאים, שבהם מוסברים מושגים וכלים בסיסיים שמשמשים לכוונון שאילתות:
- שיטות מומלצות ל-SQL
- סקירה כללית על הכלי להמחשה חזותית של תוכניות לביצוע שאילתות
- נתונים סטטיסטיים של שאילתות
- אופרטורים להרצת שאילתות
השאילתות ותוכניות הביצוע בדף הזה מבוססות על הסכימה הבאה של מסד הנתונים:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
כדי להוסיף נתונים לטבלאות האלה, אפשר להשתמש בפקודות הבאות של שפת הטיפול בנתונים (DML):
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
המלצות להשוואה לשוק
הנתונים הסטטיסטיים הכי מהימנים לגבי הביצועים מתקבלים מהרצת בדיקת עומס, שבה משתמשים בערכים אקראיים שונים של פרמטרים של שאילתות ממכונה וירטואלית (VM) של Google Cloud שנמצאת באותו אזור כמו מכונת היעד.
אל תסתמכו על Spanner Studio או על מצב QueryMode.PROFILE כדי לבצע השוואת ביצועים של שאילתות, כי הכלים האלה לא משכפלים את סביבות הרשת והלקוח בפועל בסביבת הייצור. עם זאת, אחרי שבדיקת עומסים מזהה בעיה בביצועים, תוכניות לביצוע שאילתות (בין אם נדגמו ב-Query Insights ובין אם הופעלו על פי דרישה ב-Spanner Studio) הן כלים שימושיים לחקירת הבעיה הספציפית הזו.
הסבר על תוכניות לביצוע שאילתות
בכלי להמחשה חזותית של תוכנית לביצוע שאילתה, תוכנית הרצה מוצגת כעץ של אופרטורים, שבו כל אופרטור קורא שורות מהאופרטורים הצאצאים שלו, מעבד אותן ומעביר את התוצאות לאופרטור ההורה שלו.
ברוב האופרטורים בתוכנית החזותית, זמן האחזור שמדווח הוא מצטבר (הוא משקף רק את הזמן שהושקע באופרטור הזה). עם זאת, באופרטורים Distributed union ו-Distributed apply, זמן האחזור שמדווח הוא מצטבר: הוא כולל גם את הזמן שנדרש לאופרטור המבוזר עצמו וגם את הזמן שנדרש לאופרטורים הצאצאים שלו. למידע נוסף על האופרטורים האלה, קראו את המאמרים Distributed union ו-Distributed apply.
לדוגמה, בתוכנית האיחוד המבוזרת הבאה, הכרטיס Distributed union מדווח על זמן אחזור כולל של 8.46 אלפיות השנייה, בעוד שהאופרטור הצאצא שלו Stream aggregate מדווח על 3.51 אלפיות השנייה ו-Table scan מדווח על אלפית השנייה אחת. מכיוון שזמן האחזור של Distributed union הוא מצטבר, האופרטור Distributed union עצמו מוסיף רק כ-5 אלפיות השנייה של זמן אחזור, ולא 8 אלפיות השנייה:

בדוגמה הבאה, בכרטיס Distributed union מדווח על זמן אחזור של 13.69 אלפיות השנייה, בעוד שהאופרטורים הצאצאים שלו (Stream aggregate פחות מאלפית השנייה, Cross apply 1.14 אלפיות השנייה, Table scan ב-Albums פחות מאלפית השנייה, Filter scan אלפית השנייה ו-Table scan ב-Singers 10.85 אלפיות השנייה) מהווים כ-13 אלפיות השנייה. כתוצאה מכך, האופרטור Distributed union עצמו מוסיף פחות מאלפית השנייה של זמן אחזור, ולא 13 אלפיות השנייה:

אפשר גם לראות את ערכי זמן האחזור המצטברים בחלונית הסיכום של האופרטור.
שילוב של כמה אינדקסים
כששאילתה מסננת כמה עמודות שנוספו לאינדקס באמצעות תנאי OR או AND, לפעמים Spanner יכול לשלב כמה אינדקסים משניים כדי להימנע מסריקה של מסד הנתונים הטבלאי המלא. בדוגמאות שבקטע הזה, אנחנו מרחיבים את הטבלה Albums מהסכימה לדוגמה שלמעלה, על ידי הוספת עמודה ReleaseDate ואינדקס משני AlbumsByReleaseDate:
CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  ReleaseDate     DATE,
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByReleaseDate ON Albums(ReleaseDate);
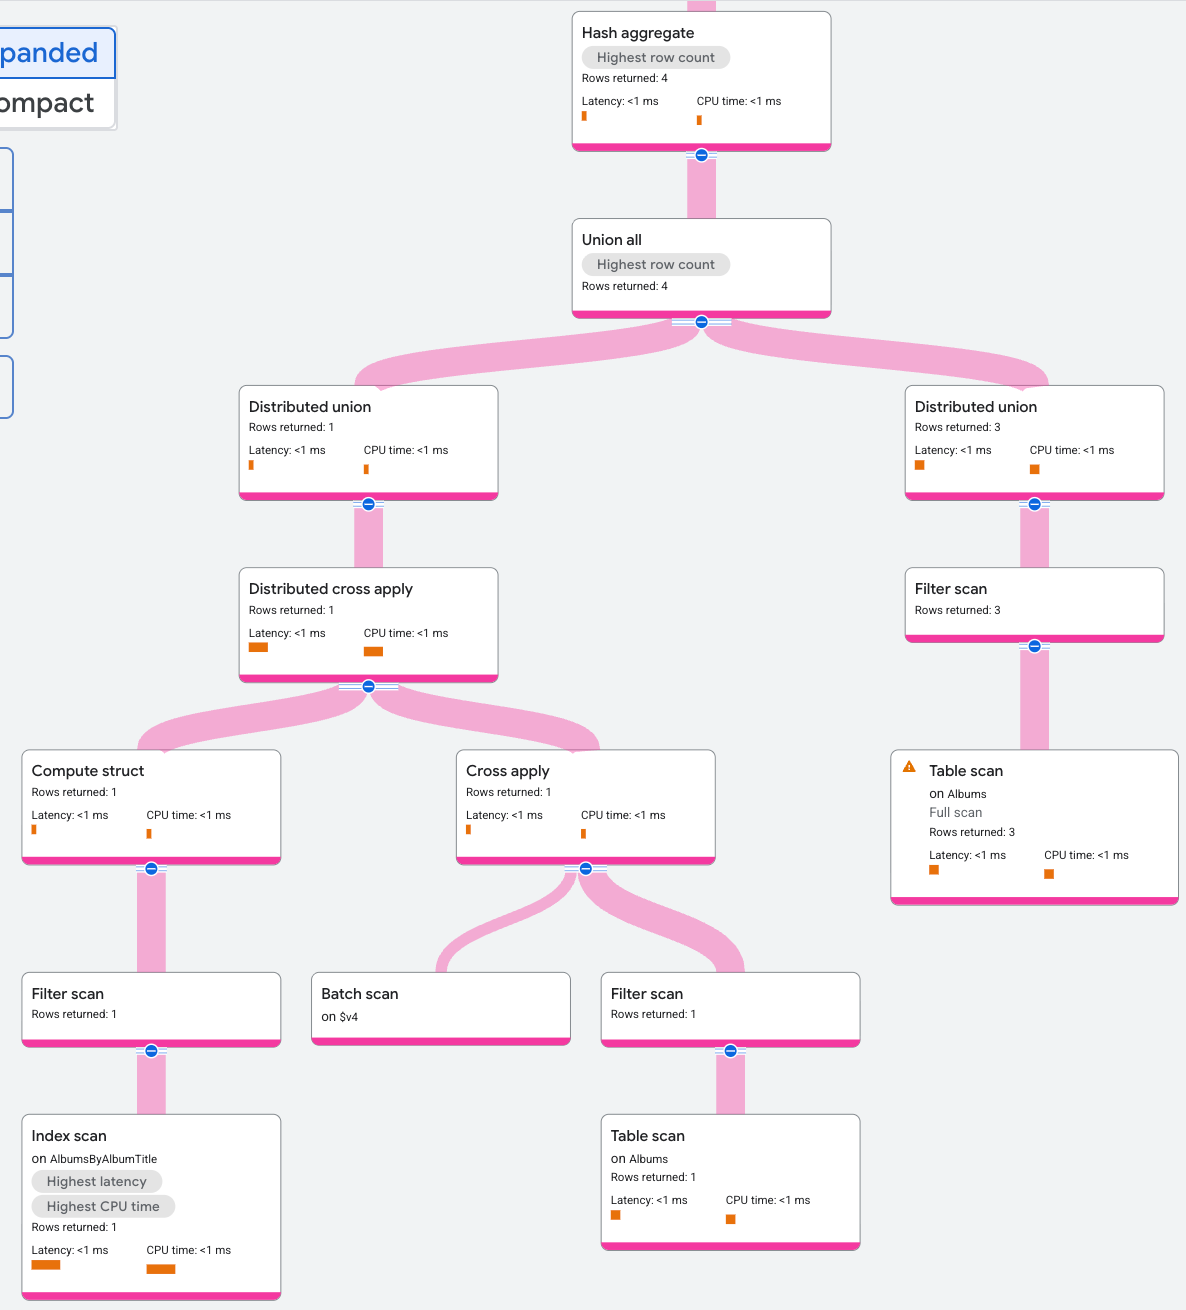
נניח שיש לכם את השאילתה הבאה, שמשתמשת בתנאי OR כדי לסנן לפי פרדיקטים משני אינדקסים משניים נפרדים (AlbumsByAlbumTitle ו-AlbumsByReleaseDate):
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
כאשר לשאילתה יש תנאי OR על פרדיקטים משני אינדקסים נפרדים, Spanner עשוי להשתמש באופטימיזציה מבוססת-עלות כדי לקרוא את שני האינדקסים ולשלב את התוצאות (איחוד אינדקסים). אפשר גם לאלץ את האופטימיזציה הזו על ידי הוספת הרמז לטבלה INDEX_STRATEGY=FORCE_INDEX_UNION לשאילתה:
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums@{INDEX_STRATEGY=FORCE_INDEX_UNION} AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
מידע נוסף על רמזים לטבלאות זמין במאמר רמזים לטבלאות.
בתרשים הבא של תוכנית הביצוע מוצג איך Spanner מעריך את התנאי OR (דיסיונקציה) על ידי סריקה של כל הסתעפות בנפרד ושילוב התוצאות באמצעות האופרטורים Union all ו-Hash aggregate:
עכשיו נבחן שאילתה שמשתמשת בתנאי AND כדי לסנן את שתי העמודות שנוספו לאינדקס:
SELECT a.AlbumId, a.ReleaseDate, a.AlbumTitle
FROM Albums AS a
WHERE a.AlbumTitle = 'Aardvark' AND a.ReleaseDate = '2023-09-07';
עם תנאי AND, כברירת מחדל Spanner בוחר אינדקס אחד ואז מצטרף בחזרה למסד הנתונים הטבלאי, אם צריך, כדי להעריך את התנאי שנותר בסעיף AND. כדי לקבוע אם האיחוד החוזר של מסד הנתונים הטבלאי הוא צוואר בקבוק בביצועים, בודקים את תוכנית הביצוע של השאילתה בכלי להמחשה חזותית: אם האופרטור Index scan מחזיר הרבה שורות שמסוננות לאחר מכן אחרי האיחוד עם האופרטור Table scan במסד הנתונים הטבלאי (מה שגורם לזמן אחזור ארוך או לזמן מעבד ארוך בענף Table scan ביחס למספר הסופי של השורות שהוחזרו), אז האיחוד החוזר הוא צוואר בקבוק.
אם צוואר הבקבוק של השאילתה הוא הצירוף החוזר של מסד הנתונים הטבלאי, הפתרון המומלץ הוא להוסיף את העמודה הנוספת בתנאי AND לסעיף STORING של האינדקס המשני, כדי ש-Spanner יוכל להעריך את שני התנאים ישירות מהאינדקס בלי לקרוא את מסד הנתונים הטבלאי:
CREATE INDEX AlbumsByAlbumTitleStoringReleaseDate
  ON Albums(AlbumTitle)
  STORING (ReleaseDate);
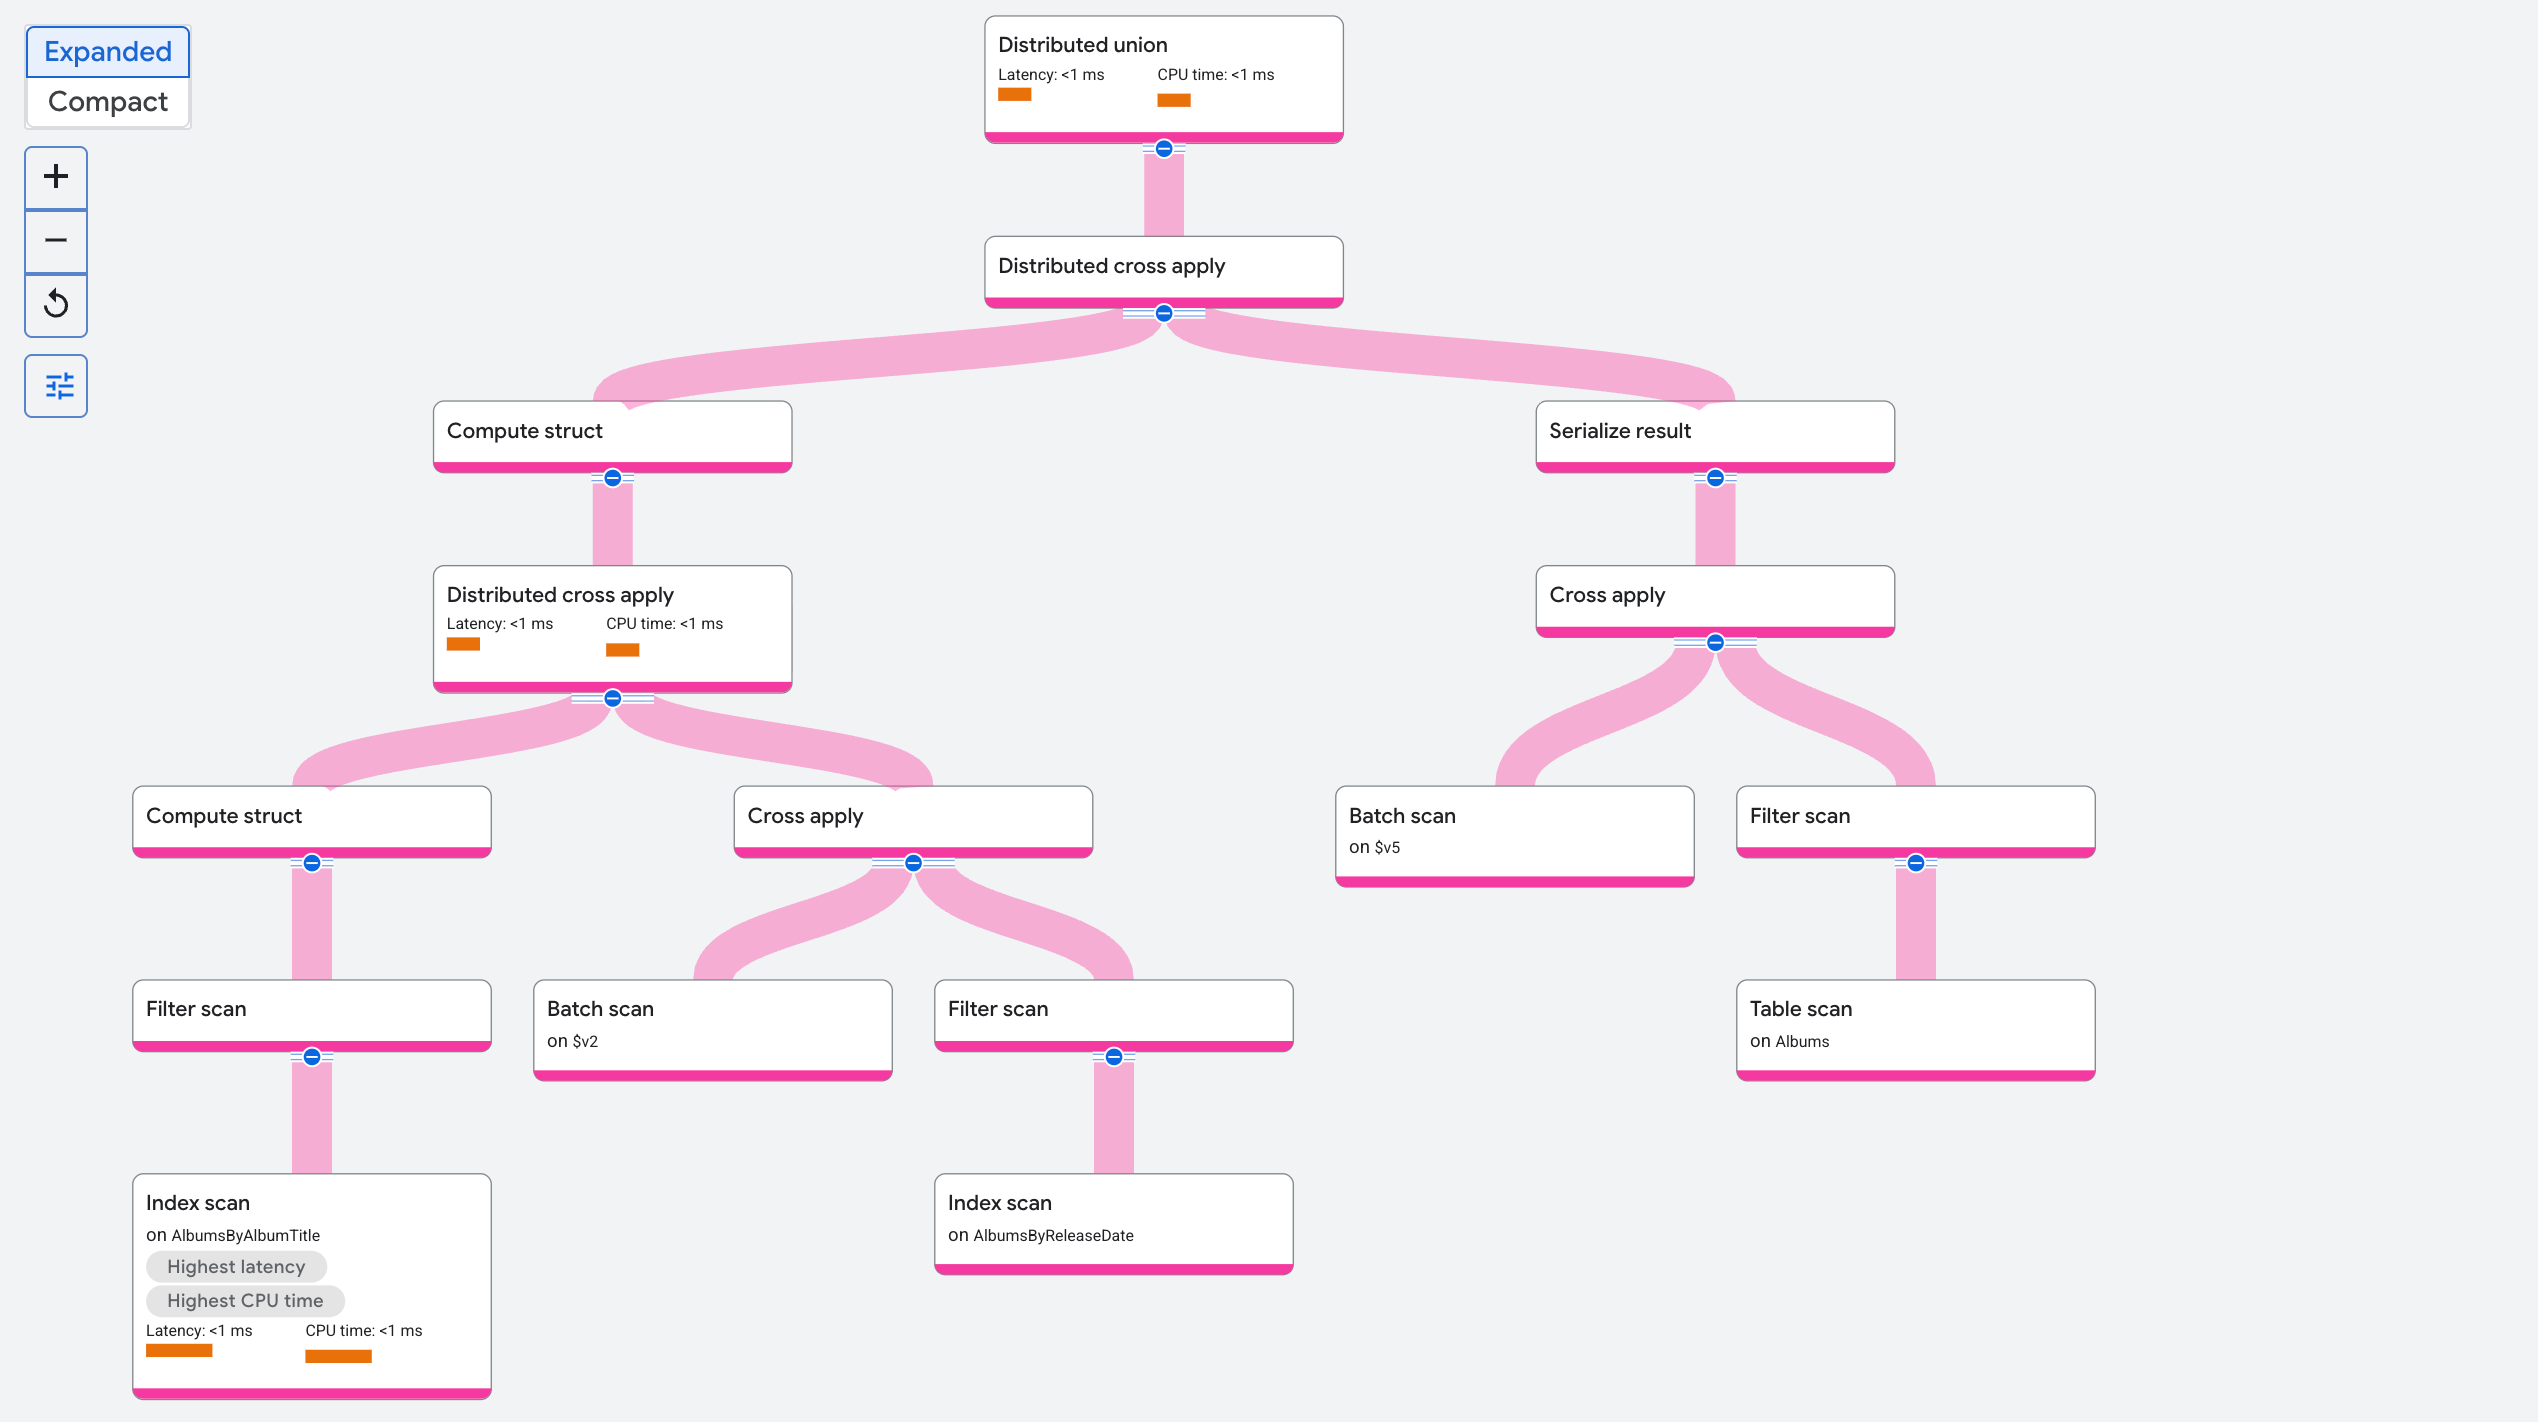
אם אי אפשר לשנות את האינדקס, אפשר לשכתב את השאילתה כדי לבצע חיתוך של שני האינדקסים באמצעות INTERSECT DISTINCT, ואז לצרף את המפתחות הראשיים התואמים בחזרה למסד הנתונים הטבלאי Albums:
SELECT union_a.AlbumId, a.ReleaseDate, a.AlbumTitle FROM
  (SELECT a1.SingerId, a1.AlbumId
  FROM Albums @{force_index=AlbumsByReleaseDate} AS a1
  WHERE a1.ReleaseDate = '2023-09-07'
  INTERSECT DISTINCT
  SELECT a2.SingerId, a2.AlbumId
  FROM Albums @{force_index=AlbumsByAlbumTitle} AS a2
  WHERE a2.AlbumTitle = 'Aardvark') AS union_a
JOIN Albums AS a
  ON a.SingerId = union_a.SingerId AND a.AlbumId = union_a.AlbumId;
בתרשים הבא של תוכנית הביצוע מוצגת השאילתה שנכתבה מחדש. שימו לב שבתוכנית נעשה שימוש בשני אופרטורים של Index scan (on AlbumsByAlbumTitle ו-on AlbumsByReleaseDate) כדי למצוא את המפתחות החופפים לפני ביצוע ה-Table scan במסד הנתונים הטבלאי Albums:
אם אתם מסננים לעיתים קרובות כמה עמודות בעומס העבודה, כדאי להשתמש בחיפוש טקסט מלא בכמה עמודות במקום באינדקסים משניים. מידע נוסף מופיע במאמר ביצוע חיפוש בכמה עמודות.
אופטימיזציה של צירופים
כש-Spanner מריץ שאילתה שמצרפת כמה טבלאות, הכלי לאופטימיזציה של שאילתות בוחר גם את סדר הצירוף (הרצף שבו הטבלאות מצורפות) וגם את שיטת הצירוף (האלגוריתם שמשמש לשילוב שורות משני קלטים, כמו צירוף מסוג apply, צירוף מסוג hash או צירוף מסוג merge). אם שאילתה עם צירוף איטית מהצפוי, אתם יכולים להשתמש ברמז לשאילתה כדי להורות ל-Spanner להשתמש בסדר צירוף או בשיטת צירוף אחרים. הפעולה הזו משנה את תוכנית הביצוע, אבל לא את התוצאות שמתקבלות. לדוגמה:
GoogleSQL
סדר הצטרפות מאולץ:
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
שינוי אופן ההצטרפות:
SELECT *
FROM Singers AS s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON s.SingerId = a.SingerId;
PostgreSQL
סדר הצטרפות מאולץ:
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
שינוי אופן ההצטרפות:
SELECT *
FROM Singers AS s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON s.SingerId = a.SingerId;
בקטעים הבאים מופיע רקע שיכול לעזור לכם לקבוע אילו סדרי איחוד ושיטות איחוד יכולים לשפר את ביצועי השאילתות.
אופן ההצטרפות וסריקות
Spanner תומך בכמה שיטות של צירוף, והשיטה שתבחרו משפיעה ישירות על האופן שבו Spanner סורק את הטבלאות או האינדקסים הבסיסיים:
- החלת איחוד (במערכות מסוימות נקרא איחוד חיפוש או איחוד לולאה מקוננת): מבצע את הצד הימני ("מפה") פעם אחת לכל שורה מהצד השמאלי ("קלט"). בגלל שכל חיפוש בצד ימין משתמש בערכים מהשורה הנוכחית בצד שמאל, אפשר להשתמש בעמודות הצירוף משמאל כמפתח חיפוש מימין. distributed apply join פועל באופן דומה ל-local apply join, אבל מקבץ שורות יחד לתקשורת יעילה יותר בין פיצולים ב-distributed join.
- איחוד גיבוב (hash): קורא שורות מקלט אחד כדי ליצור טבלת גיבוב בזיכרון במפתחות האיחוד, ואז סורק את הקלט השני כדי לבדוק אם יש התאמות בטבלת הגיבוב.
- מיזוג צירופים: קורא את שני הקלטים בסדר ממוין לפי מפתחות הצירוף וממזג שורות תואמות במעבר אחד.
לדוגמה, נניח שיש לכם את השאילתה הבאה שמחברת בין Singers ל-Albums:
SELECT s.*, a.AlbumTitle
FROM Singers AS s
JOIN Albums AS a ON s.SingerId = a.SingerId
WHERE s.SingerId = 2 AND a.AlbumId = 1;
ב-apply join, s.SingerId = a.SingerId פועל כתנאי חיפוש בצד ימין של ה-join, כך שהשאילתה צריכה לקרוא רק שורה אחת מהטבלה Albums.
לעומת זאת, ב-hash join או ב-merge join, הקלט השמאלי והימני נקראים בנפרד זה מזה, כך שתנאי ה-join לא מספק מפתח חיפוש מצד אחד לצד השני. במקרה הגרוע ביותר, איחוד מסוג hash או merge מבצע סריקה של טבלה מלאה לכל קלט.
בשאילתות אינטראקטיביות וטרנזקציונליות, רוב הצירופים משתמשים באינדקסים, ולכן החלה מבוזרת היא סוג הצירוף הנפוץ ביותר ב-Spanner. עם זאת, לפעמים עדיף להשתמש ב-hash join או ב-merge join, כי קריאה של טווח שורות רציף מהירה משמעותית מביצוע אותו מספר של חיפושים מפוזרים של שורה אחת. הפשרה היא בין חיפוש מהיר יותר של פחות שורות (באמצעות apply join) לבין סריקה של טווח שורות רציף גדול יותר (באמצעות hash join או merge join). למידע נוסף על הפשרה הזו, ראו קריאות רציפות לעומת חיפושים מפוזרים.
בשאילתות שקוראות אלפי שורות, אם יש אינדקס זמין במפתח הצירוף, בדרך כלל בטוח יותר להשתמש בצירוף מבוזר מסוג apply. הסיבה לכך היא שעלות ה-apply join היא פרופורציונלית למספר השורות שצורפו, ואילו ב-hash join או ב-merge join, העלות יכולה להיות פרופורציונלית לגודל הטבלה הכולל. בשאילתות גדולות יותר (כמו שאילתות שמעבדות מיליוני שורות), שימוש ב-hash או ב-merge join יכול לשפר את הביצועים באופן משמעותי.
למידע נוסף על אופרטורים והינטים של איחוד, עיינו במקורות המידע הבאים:
הצטרפות להזמנה
כמו במערכות אחרות לניהול מסדי נתונים יחסיים (RDBMS), צריך לסדר את הצירופים כך שגודל תוצאת הביניים יהיה קטן ככל האפשר. כלומר, לסנן נתונים מוקדם ככל האפשר, ולדחות התאמות גדולות ככל האפשר.
אם תספקו את ההנחיה FORCE_JOIN_ORDER=TRUE, Spanner יבצע את הצירופים בסדר המדויק שבו הם מופיעים בטקסט של השאילתה. העבירו את פעולות ה-JOIN עם מסננים סלקטיביים מאוד לשלב מוקדם יותר בשאילתה, ואת פעולות ה-JOIN עם התאמות גדולות לשלב מאוחר יותר בשאילתה.
אופטימיזציה של צבירות נתונים
השיטות הבאות יכולות לעזור לכם לצמצם את מספר השורות שנסרקות וממוינות במהלך שאילתות צבירה.
אחזור של שורה אחת לכל תחילית של מפתח
תבנית צבירה נפוצה היא לאחזר שורה אחת לכל קידומת מפתח (לדוגמה, השורה עם מספר הגרסה או חותמת הזמן הגבוהים ביותר). ב-GoogleSQL, הדרך הכי יעילה לעשות את זה היא להשתמש ב-ANY_VALUE עם HAVING MAX, שמוצא את השורה עם הערך המקסימלי ומחזיר את העמודה המבוקשת במעבר צבירה אחד, בלי לדרוש self-join או מיון מלא. לדוגמה, השאילתה הבאה מקבצת את הטבלה Concerts לפי ConcertDate ומחזירה את הערך BeginTime של ההופעה עם הערך EndTime האחרון לכל תאריך:
SELECT ConcertDate, ANY_VALUE(BeginTime HAVING MAX(EndTime))
FROM Concerts
GROUP BY ConcertDate;
בדיקה אם השורה קיימת
כדי לבדוק אם בטבלה יש שורות, או שורות שתואמות לתנאי מסוים, השתמשו ב-LIMIT במקום ב-COUNT. לדוגמה:
SELECT 1 FROM Albums LIMIT 1;
הגברת המקביליות
Spanner מחלק טבלאות ואינדקסים לטווחים רציפים של מפתחות ראשיים שנקראים פיצולים, שאפשר לעבד במקביל בכמה שרתים. בדרך כלל, Spanner בוחר את מקביליות השאילתות כדי לאזן בין זמן האחזור ליעילות. לדוגמה, אם שאילתה כוללת פסוקית LIMIT, יכול להיות שהיא תשתמש בפחות מקבילוּת כדי להימנע מבזבוז עבודה שהמגבלה מבטלת. מספר הפיצולים שנסרקו על ידי השאילתה מגביל את מידת ההקבלה המקסימלית.
בשאילתות עם מגבלות או סריקות גדולות, אפשר להגדיר את הרמז להצהרה USE_ADDITIONAL_PARALLELISM=TRUE כדי להורות ל-Spanner לבצע אופטימיזציה בעיקר לזמן האחזור:
GoogleSQL
@{USE_ADDITIONAL_PARALLELISM=TRUE}
SELECT *
FROM Singers
LIMIT 10;
PostgreSQL
/*@ USE_ADDITIONAL_PARALLELISM=TRUE */
SELECT *
FROM Singers
LIMIT 10;
ההנחיה הזו עלולה להעמיס על המעבד (CPU) בפיצול נתון. אם השאילתה פועלת במשך זמן רב, שלחו אותה עם עדיפות בקשה נמוכה יותר (כמו בינונית או נמוכה) כדי להימנע מהגדלת זמן האחזור של שאילתות אחרות בעדיפות גבוהה.
מגבלות ב-Optimize
אם שאילתה מכילה משפט LIMIT אבל סורקת הרבה יותר שורות מערך המגבלה, כדאי לבדוק את הסיבות האפשריות הבאות:
חסר אינדקס
אם בשאילתה יש מסנן שלא ניתן להשתמש באינדקס כדי לעמוד בתנאים שלו, התוכנית לביצוע השאילתה סורקת את מסד הנתונים הטבלאי או אינדקס שלא מספק את סדר המיון הנדרש. לאחר מכן, השאילתה ממיינת באופן מלא את הנתונים התואמים לפני הערכת הסעיף LIMIT.
כדי לפתור את הבעיה, כדאי להוסיף אינדקס משני שמכסה את עמודות הסינון. אם האינדקס מוגדר כ-NULL_FILTERED (כלומר, הוא לא כולל שורות שבהן עמודה שנוסף לה אינדקס היא NULL), צריך לוודא שהפרדיקט של השאילתה כולל את IS NOT NULL כדי שכלי האופטימיזציה יוכל להשתמש באינדקס. מידע נוסף על יצירת אינדקסים משניים זמין במאמר אינדקסים משניים.
מיון מלא
אם קיים אינדקס בעמודה המסוננת, אבל האינדקס לא מספק את סדר המיון שנדרש על ידי משפט ה-ORDER BY, Spanner צריך לקרוא את כל השורות התואמות ולהעביר אותן לאופרטור Sort בתוכנית הביצוע של השאילתה לפני החלת ה-LIMIT.
כדי להימנע ממיון מלא, צריך לציין את העמודות בהצהרת CREATE INDEX בסדר הבא:
- קודם כל, כל העמודות שיש להן תנאי שוויון (
=) אוINבשאילתה - לאחר מכן, אותן עמודות כמו בסעיף
ORDER BYשל השאילתה, באותו סדר, ובאותו כיוון מיון (ASCאוDESC)
לדוגמה, נניח שיש לכם טבלה בשם Users (שלא מופיעה בסכימה לדוגמה שלמעלה) ואתם רוצים לבצע אופטימיזציה של השאילתה הבאה:
SELECT * FROM Users
WHERE Name='Alex'
ORDER BY LastLogin DESC
LIMIT 10;
יוצרים אינדקס ב-(Name, LastLogin DESC) כדי ש-Spanner יוכל לקרוא את 10 השורות הראשונות ישירות בסדר האינדקס בלי למיין:
CREATE INDEX UsersByNameLastLogin ON Users(Name, LastLogin DESC);
סידור לפי סיומת המפתח
גם אם אינדקס כולל את העמודה ORDER BY כסיומת של מפתח האינדקס, יכול להיות ששאילתה עדיין תסרוק שורות נוספות אם יש פרדיקט IN, OR או טווח באחת מעמודות הקידומת של האינדקס.
לדוגמה, נבחן את השאילתה הבאה שמשתמשת באינדקס (Name, LastLogin DESC) מהדוגמה הקודמת של מיון מלא, שלא נכלל בסכימה לדוגמה:
SELECT *
FROM Users
WHERE Name IN ('Alex','Amal')
ORDER BY LastLogin DESC
LIMIT 10;
בגלל שהערך Name תואם לכמה ערכים, השורות התואמות לא מאוחסנות בטווח אחד שממוין באופן גלובלי לפי LastLogin DESC. אפשר לשנות את מבנה השאילתה באמצעות UNNEST וצירוף, כדי ש-Spanner ישלוף את השורות העליונות לכל ערך של Name בנפרד ואז ישלב אותן:
SELECT *
FROM UNNEST(['Alex','Amal']) AS Name
JOIN Users AS u ON u.Name = Name
ORDER BY LastLogin DESC
LIMIT 10;
השכתוב הזה מוביל לסריקות יעילות יותר, כי הוא קורא את המספר המינימלי של שורות מכל מפתח קידומת מוגבל ('Alex' ו-'Amal'), ואז מבצע מיון קטן של התוצאות המשולבות כדי להפיק את ה-LIMIT הסופי.
מקרה מיוחד ונפוץ של הדפוס הזה הוא קידומת של פיצול, שבו מוסיפים עמודת ShardId כעמודת המפתח המובילה כדי לפזר את פעולות הכתיבה בין הפיצולים.
לדוגמה, השאילתה הבאה סורקת 32 פיצולים (מ-0 עד 31):
SELECT *
FROM Users
WHERE ShardId BETWEEN 0 AND 31
ORDER BY LastLogin DESC
LIMIT 10;
כדי לבצע אופטימיזציה של השאילתה הזו, צריך למנות באופן מפורש את מזהי המקטעים (0 עד 31) ולצרף אותם לטבלה Users באמצעות GENERATE_ARRAY ב-GoogleSQL או generate_series ב-PostgreSQL:
GoogleSQL
SELECT *
FROM GENERATE_ARRAY(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
PostgreSQL
SELECT *
FROM generate_series(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
מידע נוסף על הפונקציות האלה ליצירת מערכים וסדרות זמין במאמרים GENERATE_ARRAY ל-GoogleSQL ו-generate_series ל-PostgreSQL.
הסבר על ביצועי הסריקה
בקטעים הבאים מתוארות הסיבות הנפוצות ביותר לסריקות איטיות של טבלאות או אינדקסים, ואיך לצמצם אותן.
שורות שנמחקו
כברירת מחדל, Spanner שומר שורות שנמחקו או הוחלפו למשך שעה אחת כדי לתמוך בקריאות היסטוריות ובשחזור מערכת מנקודה מסוימת בזמן (PITR). אתם יכולים להאריך את תקופת השמירה הזו עד שבעה ימים. אחרי שגרסה ישנה של שורה עוברת את תקופת השמירה, אפשר להסיר אותה במהלך דחיסת האחסון ברקע, שיכולה להימשך עד שבעה ימים נוספים. עד שגרסת השורה הישנה נדחסת, יכול להיות ששאילתות שסורקות את טווח המפתחות יצטרכו לקרוא את גרסאות השורות שנמחקו או הוחלפו ולסנן אותן. למידע נוסף על שמירת נתונים, ראו שחזור נתונים מנקודה מסוימת בזמן (PITR).
כדי לבדוק אם שאילתה סרקה שורות שנמחקו, בודקים את המדד Deleted rows scanned בתצוגת הפרטים של האופרטור Scan בחלונית הפרטים של הכלי להמחשה חזותית של תוכנית לביצוע שאילתה.
כדי לצמצם סריקות איטיות שנגרמות בגלל מספר גדול של שורות שנמחקו לאחרונה, אתם יכולים להפעיל דחיסת נתונים ידנית. למידע נוסף, ראו דחיסת נתונים ידנית.
שורות גדולות
בשורות קטנות (עד כמה מאות בייטים), עלות הסריקה תלויה בעיקר במספר השורות שנסרקו. ככל שגודל השורה גדל, גודל הבייטים של השורות הופך להיות משמעותי יותר. באחסון שמבוסס על שורות, הגודל הכולל של השורה משפיע על ביצועי הסריקה, ולא רק הגודל של העמודות שמוצגות בשאילתה.
בשאילתות ניתוח שכוללות הרבה סריקות בטבלאות גדולות, כדאי להשתמש במנוע מבוסס-עמודות. מידע נוסף זמין במאמר מעקב אחרי המנוע מבוסס-העמודות.
אם אתם רוצים לשלוח שאילתות על קבוצות קטנות יותר של שורות, ואם בטבלה יש גם עמודות גדולות וגם עמודות קטנות יותר שאתם שולחים אליהן שאילתות לעיתים קרובות, כדאי לשקול את האפשרויות הבאות:
- מפרידים את העמודות הגדולות יותר לקבוצת מיקום שאינה ברירת מחדל (שמאחסנת עמודות שצוינו בנפרד בדיסק משאר הטבלה) או לטבלת צאצא נפרדת, כך שסריקות של העמודות הקטנות יותר לא קוראות את נתוני העמודות הגדולות. מידע נוסף זמין במאמר יצירה וניהול של קבוצות לפי מיקום.
- כדי לבצע אופטימיזציה נוספת של זמן הקריאה, שכפלו את העמודות הקטנות יותר לאינדקס משני עם אותו מפתח ראשי כמו מסד הנתונים הטבלאי, באמצעות הסעיף
STORINGכדי לכלול את העמודות הקטנות יותר.
לדוגמה, נניח שבטבלה Documents (שלא נכללת בסכימה של הדוגמה הקודמת) מאוחסנת מחרוזת Metadata קטנה לצד אובייקט JSON גדול של Content. אפשר ליצור אינדקס משני שמאחסן רק את Metadata, כך ששאילתות שלא צריכות את Content יכולות לסרוק את האינדקס הקטן יותר במקום את מסד הנתונים הטבלאי:
CREATE TABLE Documents (
  Id INT64,
  Metadata STRING(MAX),
  Content JSON
) PRIMARY KEY (Id);

CREATE INDEX DocumentMetadata ON Documents(Id) STORING (Metadata);
נתונים משולבים גדולים
כשהטבלאות משולבות, Spanner מאחסן פיזית כל שורת הורה יחד עם שורות הצאצא המשולבות שלה, לפי סדר המפתחות. אם לטבלת הורה יש הרבה שורות צאצא משולבות, או אם לטבלת צאצא יש הרבה פחות שורות מאשר לטבלת ההורה או לטבלאות האחים שלה, סריקות הטווח בטבלה הקטנה יותר הן דלילות יותר ופחות יעילות, כי הסריקה צריכה לדלג על השורות המשולבות מהטבלאות האחרות.
לדוגמה, נבחן את הסכימה הבאה (לא חלק מסכימת הדוגמה הקודמת), שבה גם Transaction וגם AuthorizedPerson משולבות ב-Account:
CREATE TABLE Account (
  AccountId INT64,
  -- Additional columns omitted
) PRIMARY KEY (AccountId);

CREATE TABLE Transaction (
  AccountId INT64,
  TransactionId STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, TransactionId),
INTERLEAVE IN PARENT Account;

CREATE TABLE AuthorizedPerson (
  AccountId INT64,
  SignerId INT64,
  Name STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, SignerId),
INTERLEAVE IN PARENT Account;
אם לכל שורה ב-Account יש אלפי שורות ב-Transaction ורק כמה שורות ב-AuthorizedPerson, לעלות של סריקת טווח ב-Account או ב-AuthorizedPerson לכל שורה תהיה עלות גבוהה יותר מאשר לסריקת טווח ב-Transaction (למרות שהעלות הכוללת שלה עדיין נמוכה יותר). זה קורה כי סריקה של Transaction קוראת הרבה שורות Transaction סמוכות בבת אחת, ואילו בסריקה של Account או AuthorizedPerson יש פחות שורות סמוכות באותה טבלה, וצריך לדלג על שורות Transaction המשולבות.
כדי לבצע אופטימיזציה של סריקות טווח בטבלה הדלילה יותר (Account או AuthorizedPerson), צרו אינדקס משני לא משולב שמשכפל את העמודות שנדרשות לשאילתה, בדומה לגישה של שורות גדולות:
CREATE INDEX AuthorizedPersonByAccount
  ON AuthorizedPerson(AccountId, SignerId)
  STORING (Name);
שימוש בהפעלה מבוססת-אצווה
Spanner יכול להריץ סריקות של שאילתות ואופרטורים של שאילתות באמצעות שיטה שמבוססת על שורות (עיבוד של שורה אחת בכל פעם) או שיטה שמבוססת על אצוות (עיבוד של בלוקים של שורות בכל פעם). בקטעים הבאים מוסבר איך לבדוק ולהגדיר סריקות מבוססות-אצווה והפעלת אופרטורים מבוססי-אצווה.
סריקות מבוססות-אצווה
בשאילתות מסוימות ב-Spanner, יכול להיות שעדיף להשתמש בשיטת עיבוד מבוססת-אצווה כשסורקים נתונים, במקום בשיטת העיבוד הנפוצה יותר שמבוססת על שורות. עיבוד סריקות באצוות הוא דרך יעילה יותר לעבד כמויות גדולות של נתונים בבת אחת, והוא מאפשר לשאילתות להשיג ניצול נמוך יותר של המעבד (CPU) וזמן אחזור קצר יותר.
פעולת הסריקה של Spanner תמיד מתחילה לפעול בשיטה שמבוססת על שורות. במהלך הזמן הזה, Spanner אוסף כמה מדדי זמן ריצה. לאחר מכן, Spanner מחיל קבוצה של שיטות היוריסטיות על סמך התוצאה של המדדים האלה כדי לקבוע את שיטת הסריקה האופטימלית. במקרים המתאימים, Spanner עובר לשיטת עיבוד מבוססת-אצווה כדי לשפר את קצב העיבוד והביצועים של הסריקה.
תרחישים נפוצים לדוגמה
שאילתות עם המאפיינים הבאים בדרך כלל נהנות מעיבוד מבוסס-אצווה:
- סריקות גדולות של נתונים שמתעדכנים לעיתים רחוקות
- סריקות עם פרדיקטים בעמודות ברוחב קבוע
- סריקות עם מספר גדול של פעולות חיפוש (פעולת חיפוש משתמשת באינדקס כדי לאחזר רשומות)
תרחישים לדוגמה שבהם אין שיפור בביצועים
לא כל השאילתות מפיקות תועלת מעיבוד באצווה. סוגי השאילתות הבאים פועלים טוב יותר עם עיבוד סריקה שמתמקד בשורות:
- שאילתות חיפוש נקודתיות: שאילתות שמאחזרות רק שורה אחת.
- שאילתות סריקה קטנות: סריקות טבלה שסורקות רק כמה שורות, אלא אם יש להן מספר גדול של חיפושים.
- שאילתות עם משפט
LIMIT: שאילתות שמפסיקות את הסריקה אחרי שהן מחזירות מספר קבוע של שורות. - שאילתות שקוראות נתונים עם שיעור נטישה גבוה: שאילתות שבהן יותר מ-10% בערך מהנתונים שנקראים מתעדכנים לעיתים קרובות.
- שאילתות עם שורות שמכילות ערכים גדולים: שאילתות על שורות שמכילות ערכים גדולים מ-32,000 בייטים (לפני דחיסה) בעמודה אחת.
בדיקת שיטת הסריקה שבה נעשה שימוש בשאילתה
כדי לבדוק אם השאילתה משתמשת בעיבוד מבוסס-אצווה, בעיבוד מבוסס-שורה או עוברת אוטומטית בין שתי שיטות הסריקה, פועלים לפי השלבים הבאים:
נכנסים לדף Instances של Spanner במסוף Google Cloud .
לוחצים על שם המכונה עם השאילתה שרוצים לחקור.
בטבלה Databases, לוחצים על מסד הנתונים עם השאילתה שרוצים לחקור.
בתפריט הניווט של Spanner, לוחצים על Spanner Studio.
לוחצים על New SQL editor tab או על New tab.
מזינים את השאילתה בעורך השאילתות.
לוחצים על Run.
Spanner מריץ את השאילתה ומציג את התוצאות.
בחלונית של עורך השאילתות, לוחצים על הכרטיסייה Explanation.
ב-Spanner מוצג הכלי להמחשה חזותית של תוכנית הביצוע של השאילתה. כל כרטיס בתרשים מייצג איטרטור. מידע נוסף על תוכניות ביצוע זמין במאמר תוכניות ביצוע של שאילתות.
לוחצים על כרטיס האיטרטור Table scan כדי לפתוח חלונית מידע.
בחלונית המידע מוצג מידע לפי הקשר על הסריקה שנבחרה, כולל שיטת הסריקה (Method). Automatic מציין ש-Spanner קובע את שיטת הסריקה. ערכים אפשריים אחרים כוללים את Batch לעיבוד מבוסס-אצווה ואת Row לעיבוד מבוסס-שורה, כפי שמוצג בתמונה הבאה:

אכיפת שיטת הסריקה שבה משתמשת שאילתה
כדי לשפר את ביצועי השאילתות, Spanner בוחר את שיטת הסריקה האופטימלית לשאילתה. Google ממליצה להשתמש בשיטת הסריקה הזו שמוגדרת כברירת מחדל. עם זאת, יכול להיות שתרצו לאכוף שיטת סריקה ספציפית.
אכיפת סריקה מבוססת-אצווה
אפשר לאכוף סריקה מבוססת-אצווה ברמת הטבלה וברמת ההצהרה.
כדי לאכוף את שיטת הסריקה מבוססת-האצווה ברמת הטבלה, משתמשים ברמז לטבלה בשאילתה:
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=BATCH} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=batch */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
כדי לאכוף את שיטת הסריקה מבוססת-האצווה ברמת ההצהרה, משתמשים ברמז להצהרה בשאילתה:
GoogleSQL
@{SCAN_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=batch */
SELECT *
FROM Singers;
כשמשתמשים בהנחיה ברמת ההצהרה, היא חלה על כל השאילתה. עדיף להגדיר את הרמז ברמת הטבלה, כי זה מאפשר שליטה ברמת פירוט גבוהה יותר.
אילוץ סריקה לפי שורות
למרות ש-Google לא ממליצה להשבית את שיטת הסריקה האוטומטית שמוגדרת על ידי Spanner, אתם יכולים להשבית אותה ולהשתמש בשיטת הסריקה לפי שורות כדי לפתור בעיות, כמו אבחון זמן אחזור.
כדי להשבית את הבחירה האוטומטית של שיטת הסריקה ולאכוף עיבוד שורות ברמת הטבלה, אפשר להשתמש ברמז לטבלה בשאילתה:
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=ROW} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=row */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
כדי להשבית את שיטת הסריקה האוטומטית ולאכוף עיבוד שורות ברמת ההצהרה, צריך להשתמש ברמז להצהרה בשאילתה:
GoogleSQL
@{SCAN_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=row */
SELECT *
FROM Singers;
שיטת הביצוע
בנוסף לסריקות מבוססות-אצווה, אתם יכולים גם לבצע אופטימיזציה של הרצת השאילתות על ידי אכיפת שיטת ההרצה ברמת ההצהרה. האפשרות הזו פועלת רק בחלק מהאופרטורים, והיא לא תלויה בשיטת הסריקה, שמשמשת רק את אופרטור הסריקה. מידע נוסף על סריקות מבוססות-אצווה זמין בקטע סריקות מבוססות-אצווה במסמך הזה.
כברירת מחדל, רוב האופרטורים פועלים בשיטה מבוססת-שורות, שבה הנתונים מעובדים שורה אחר שורה. אופרטורים וקטוריים פועלים בשיטה מבוססת-אצווה כדי לשפר את קצב העיבוד ואת הביצועים. האופרטורים האלה מעבדים את הנתונים בלוק אחד בכל פעם. כשצריך לעבד הרבה שורות, שיטת הביצוע שמבוססת על אצווה בדרך כלל יעילה יותר.
שיטת ההפעלה לעומת שיטת הסריקה
שיטת הרצת השאילתה לא תלויה בשיטת הסריקה של השאילתה. אתם יכולים להגדיר אחת מהשיטות האלה, את שתיהן או אף אחת מהן בהנחיית השאילתה.
שיטת הרצת השאילתה מתייחסת לאופן שבו אופרטורים של שאילתות מעבדים תוצאות ביניים ולאופן שבו האופרטורים יוצרים אינטראקציה זה עם זה, ואילו שיטת הסריקה מתייחסת לאופן שבו אופרטור הסריקה יוצר אינטראקציה עם שכבת האחסון של Spanner.
אכיפת שיטת הביצוע שבה משתמשת השאילתה
כדי לשפר את ביצועי השאילתות, Spanner בוחר את שיטת הביצוע האופטימלית לשאילתה על סמך שיטות היוריסטיות שונות. Google ממליצה להשתמש בשיטת ההפעלה הזו כברירת מחדל. עם זאת, יכול להיות שתרצו לאכוף שיטת הפעלה מסוימת.
אתם יכולים לאכוף את שיטת הביצוע ברמת ההצהרה. ההנחיה לשאילתה EXECUTION_METHOD היא המלצה ולא הוראה. בסופו של דבר, הכלי לאופטימיזציה של שאילתות מחליט באיזו שיטה להשתמש לכל אופרטור בנפרד.
כדי לאכוף את שיטת הביצוע מבוססת-האצווה ברמת ההצהרה, משתמשים ברמז להצהרה בשאילתה:
GoogleSQL
@{EXECUTION_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=BATCH */
SELECT *
FROM Singers;
למרות ש-Google לא ממליצה להשבית את שיטת הביצוע האוטומטית שמוגדרת על ידי Spanner, אתם יכולים להשבית אותה ולהשתמש בשיטת הביצוע שמכוונת לשורות למטרות פתרון בעיות, כמו אבחון זמן אחזור.
כדי להשבית את שיטת ההרצה האוטומטית ולאכוף את שיטת ההרצה לפי שורות ברמת ההצהרה, משתמשים ברמז להצהרה בשאילתה:
GoogleSQL
@{EXECUTION_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=ROW */
SELECT *
FROM Singers;
איך בודקים איזו שיטת הפעלה מוגדרת
לא כל האופרטורים של Spanner תומכים גם בשיטות ביצוע מבוססות-אצווה וגם בשיטות ביצוע מבוססות-שורה. לכל אופרטור, בכלי להמחשה חזותית של תוכנית הרצת השאילתה מוצגת שיטת ההרצה בכרטיס האיטרטור. אם שיטת הביצוע היא באצ', יופיע הערך Batch. אם הוא מבוסס-שורות, מוצג הערך Row. למידע נוסף על הכלי להמחשה חזותית, ראו תוכניות להרצת שאילתות.
אם האופרטורים בשאילתה מופעלים בשיטות הפעלה שונות, מתאמי שיטות ההפעלה DataBlockToRowAdapter ו-RowToDataBlockAdapter מופיעים בין האופרטורים כדי להראות את השינוי בשיטת ההפעלה. למידע נוסף על האופרטורים האלה, קראו את המאמרים DataBlockToRowAdapter ו-RowToDataBlockAdapter.