


Respons terhadap permintaan pemrosesan berisi objek Document
yang menyimpan semua hal yang diketahui tentang dokumen yang diproses, termasuk semua
informasi terstruktur yang dapat diekstrak oleh Document AI.
Halaman ini menjelaskan tata letak objek Document dengan memberikan contoh dokumen,
lalu memetakan aspek hasil OCR ke elemen tertentu dari JSON objek Document.
Halaman ini juga menyediakan contoh kode library klien dan contoh kode Document AI Toolbox SDK.
Contoh kode ini menggunakan pemrosesan online, tetapi penguraian objek Document berfungsi
sama untuk batch processing.
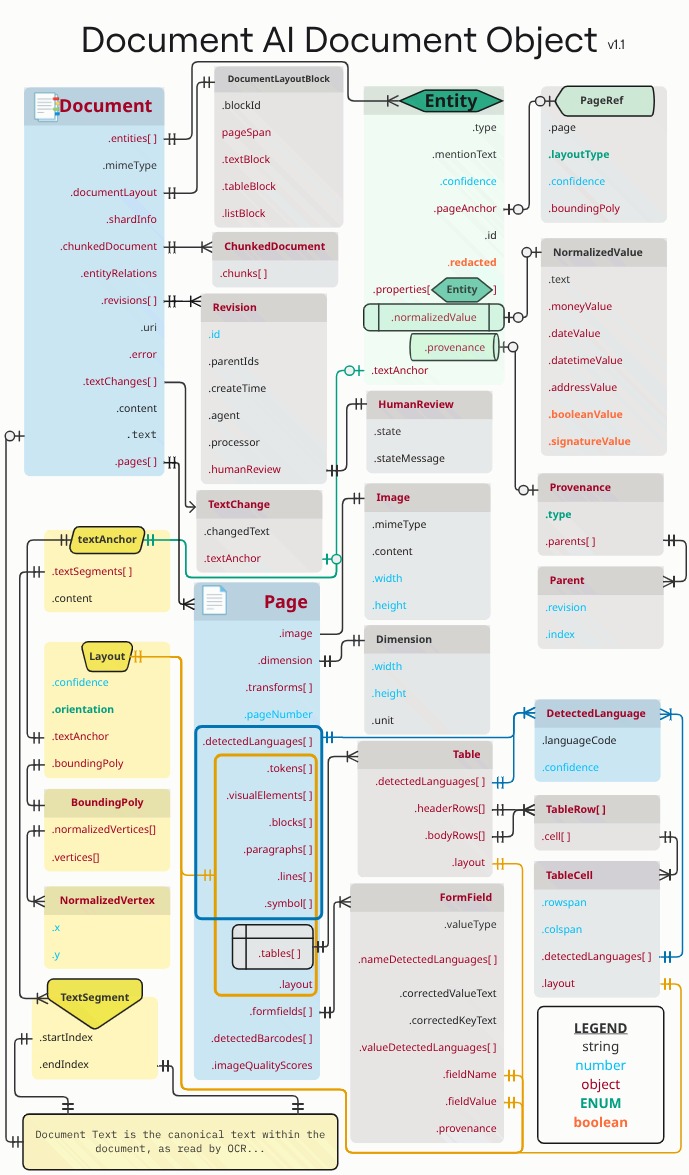
Persegi panjang dan panah berwarna oranye dan biru menunjukkan bahwa setidaknya satu kolom dari
objek yang terhubung adalah .layout atau detectedLanguage. Diagram ini menggunakan notasi
crow's foot.
Gunakan utilitas pengeditan atau penampil JSON yang dirancang khusus untuk meluaskan atau menciutkan elemen. Meninjau JSON mentah dalam utilitas teks biasa tidak efisien.
Skor teks, tata letak, dan kualitas
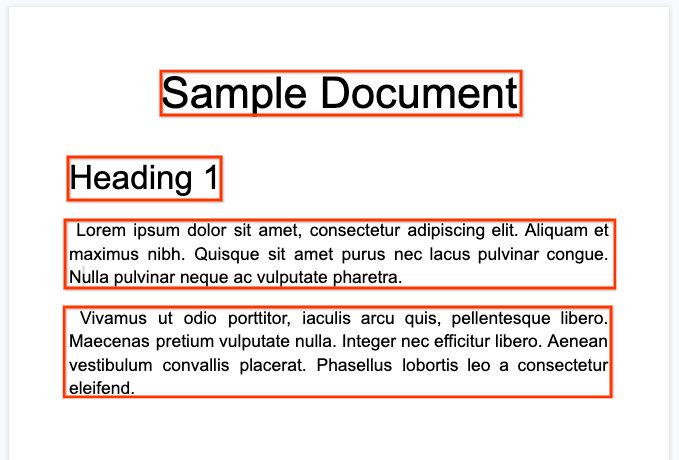
Berikut adalah contoh dokumen teks:
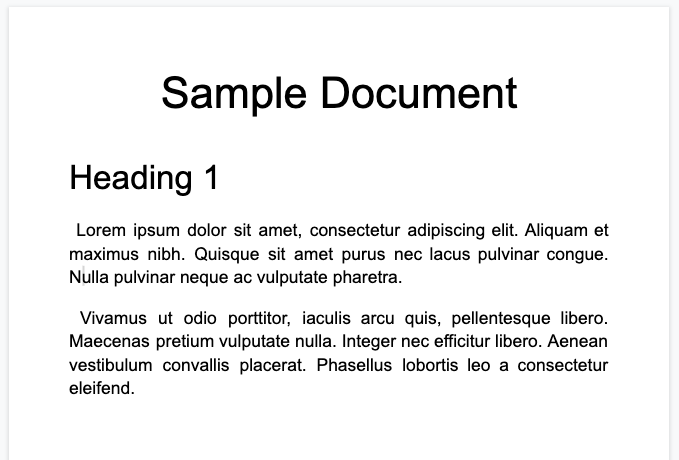
Berikut adalah objek dokumen lengkap yang ditampilkan oleh pemroses Enterprise Document OCR:
Output OCR ini juga selalu disertakan dalam output pemroses Document AI, karena OCR dijalankan oleh pemroses. Pemroses ini menggunakan data OCR yang ada, sehingga Anda dapat memasukkan data JSON tersebut menggunakan opsi dokumen inline ke pemroses Document AI.
  image=None, # all our samples pass this var
  mime_type="application/json",
  inline_document=document_response # pass OCR output to CDE input - undocumented
Berikut beberapa kolom penting:
Teks mentah
Kolom text berisi teks yang dikenali oleh Document AI.
Teks ini tidak berisi struktur tata letak apa pun selain spasi, tab, dan
line feed. Ini adalah satu-satunya kolom yang menyimpan informasi tekstual dokumen dan berfungsi sebagai sumber tepercaya teks dokumen. Kolom lain dapat merujuk ke bagian kolom teks berdasarkan posisi (startIndex dan endIndex).
  {
    text: "Sample Document\nHeading 1\nLorem ipsum dolor sit amet, ..."
  }
Ukuran halaman dan bahasa
Setiap page dalam objek dokumen sesuai dengan halaman fisik dari dokumen contoh. Contoh output JSON berisi satu halaman karena merupakan satu gambar PNG.
  {
    "pages:" [
      {
        "pageNumber": 1,
        "dimension": {
          "width": 679.0,
          "height": 460.0,
          "unit": "pixels"
        },
      }
    ]
  }
- Kolom
pages[].detectedLanguages[]berisi bahasa yang ditemukan di halaman tertentu, beserta skor keyakinan.
{
  "pages": [
    {
      "detectedLanguages": [
        {
          "confidence": 0.98009938,
          "languageCode": "en"
        },
        {
          "confidence": 0.01990064,
          "languageCode": "und"
        }
      ]
    }
  ]
}
Data OCR
Document AI OCR mendeteksi teks dengan berbagai tingkat perincian atau pengaturan di halaman, seperti blok teks, paragraf, token, dan simbol (tingkat simbol bersifat opsional, jika dikonfigurasi untuk menghasilkan data tingkat simbol). Semua ini adalah anggota objek halaman.
Setiap elemen memiliki layout yang sesuai yang
menjelaskan posisi dan teksnya. Elemen visual non-teks
(seperti kotak centang) juga berada di tingkat halaman.
{
  "pages": [
    {
      "paragraphs": [
        {
          "layout": {
            "textAnchor": {
              "textSegments": [
                {
                  "endIndex": "16"
                }
              ]
            },
            "confidence": 0.9939527,
            "boundingPoly": {
              "vertices": [ ... ],
              "normalizedVertices": [ ... ]
            },
            "orientation": "PAGE_UP"
          }
        }
      ]
    }
  ]
}
Teks mentah dirujuk dalam objek textAnchor
yang diindeks ke dalam string teks utama dengan startIndex dan endIndex.
Untuk
boundingPoly, pojok kiri atas halaman adalah origin(0,0). Nilai X positif berada di sebelah kanan, dan nilai Y positif berada di bawah.Objek
verticesmenggunakan koordinat yang sama dengan gambar asli, sedangkannormalizedVerticesberada dalam rentang[0,1]. Ada matriks transformasi yang menunjukkan ukuran deskewing dan atribut lain dari normalisasi gambar.
- Untuk menggambar
boundingPoly, gambar segmen garis dari satu verteks ke verteks berikutnya. Kemudian, tutup poligon dengan menggambar segmen garis dari verteks terakhir kembali ke verteks pertama. Elemen orientation tata letak menunjukkan apakah teks telah diputar relatif terhadap halaman.
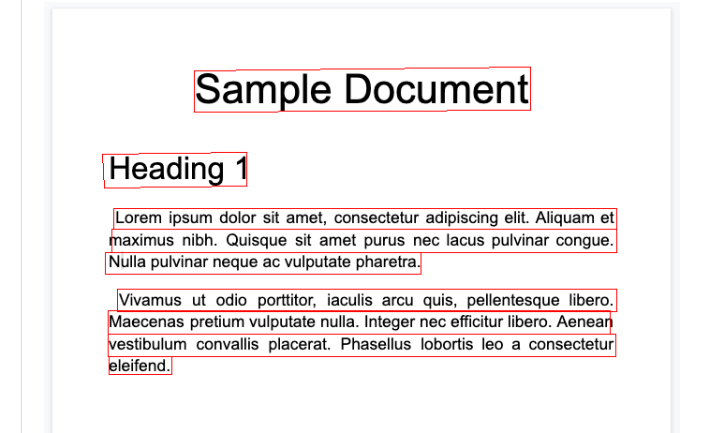
Untuk membantu Anda memvisualisasikan struktur dokumen, gambar berikut menggambar poligon pembatas untuk page.paragraphs, page.lines, page.tokens.
Paragraf

Garis
Token
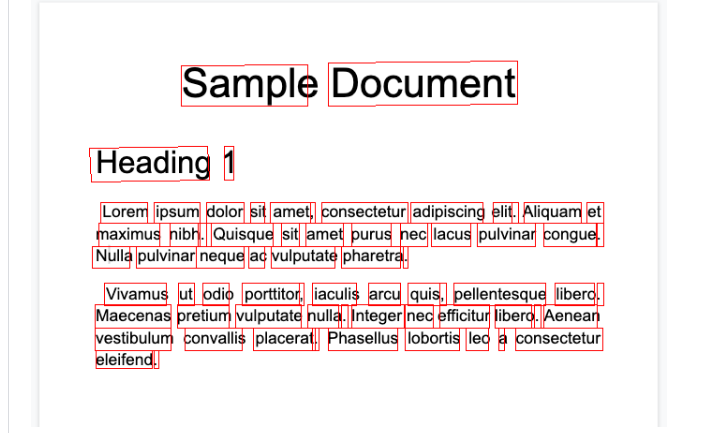
Blok
Pemroses Enterprise Document OCR dapat melakukan penilaian kualitas dokumen berdasarkan keterbacaannya.
- Anda harus menetapkan kolom
processOptions.ocrConfig.enableImageQualityScoresketrueuntuk mendapatkan data ini dalam respons API.
Penilaian kualitas ini adalah skor kualitas di [0, 1], dengan 1 berarti kualitas sempurna.
Skor kualitas ditampilkan di kolom Page.imageQualityScores.
Semua cacat yang terdeteksi dicantumkan sebagai quality/defect_* dan diurutkan dalam urutan menurun berdasarkan tingkat keyakinan.
Berikut adalah PDF yang terlalu gelap dan buram sehingga tidak nyaman dibaca:
Berikut adalah informasi kualitas dokumen yang ditampilkan oleh pemroses Enterprise Document OCR:
  {
    "pages": [
      {
        "imageQualityScores": {
          "qualityScore": 0.7811847,
          "detectedDefects": [
            {
              "type": "quality/defect_document_cutoff",
              "confidence": 1.0
            },
            {
              "type": "quality/defect_glare",
              "confidence": 0.97849524
            },
            {
              "type": "quality/defect_text_cutoff",
              "confidence": 0.5
            }
          ]
        }
      }
    ]
  }
Contoh kode
Contoh kode berikut menunjukkan cara mengirim permintaan pemrosesan, lalu membaca dan mencetak kolom ke terminal:
Java
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Java Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Node.js
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Node.js Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Python
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Python Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Formulir dan tabel
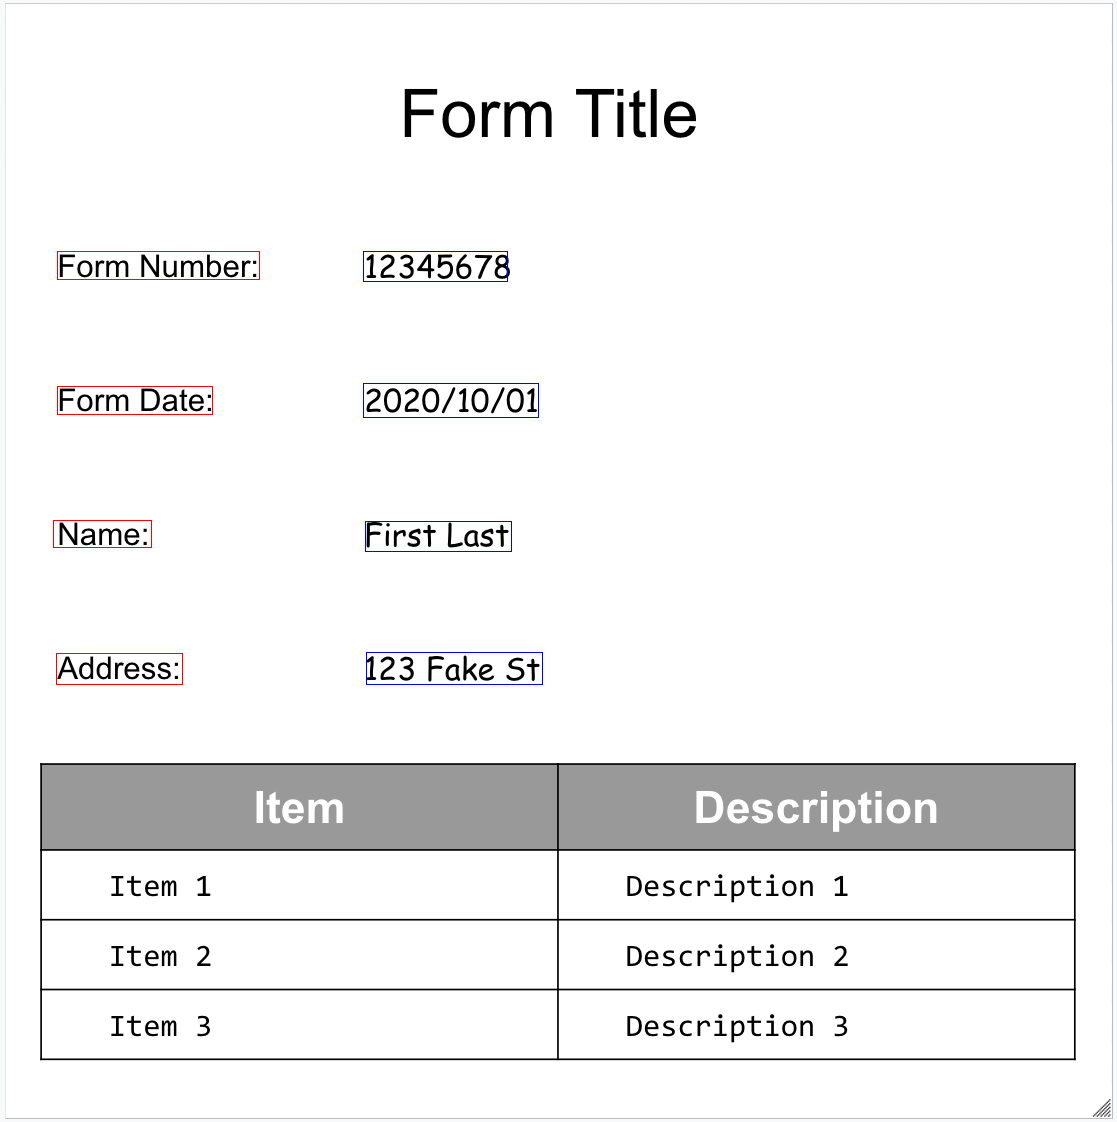
Berikut contoh formulir kami:
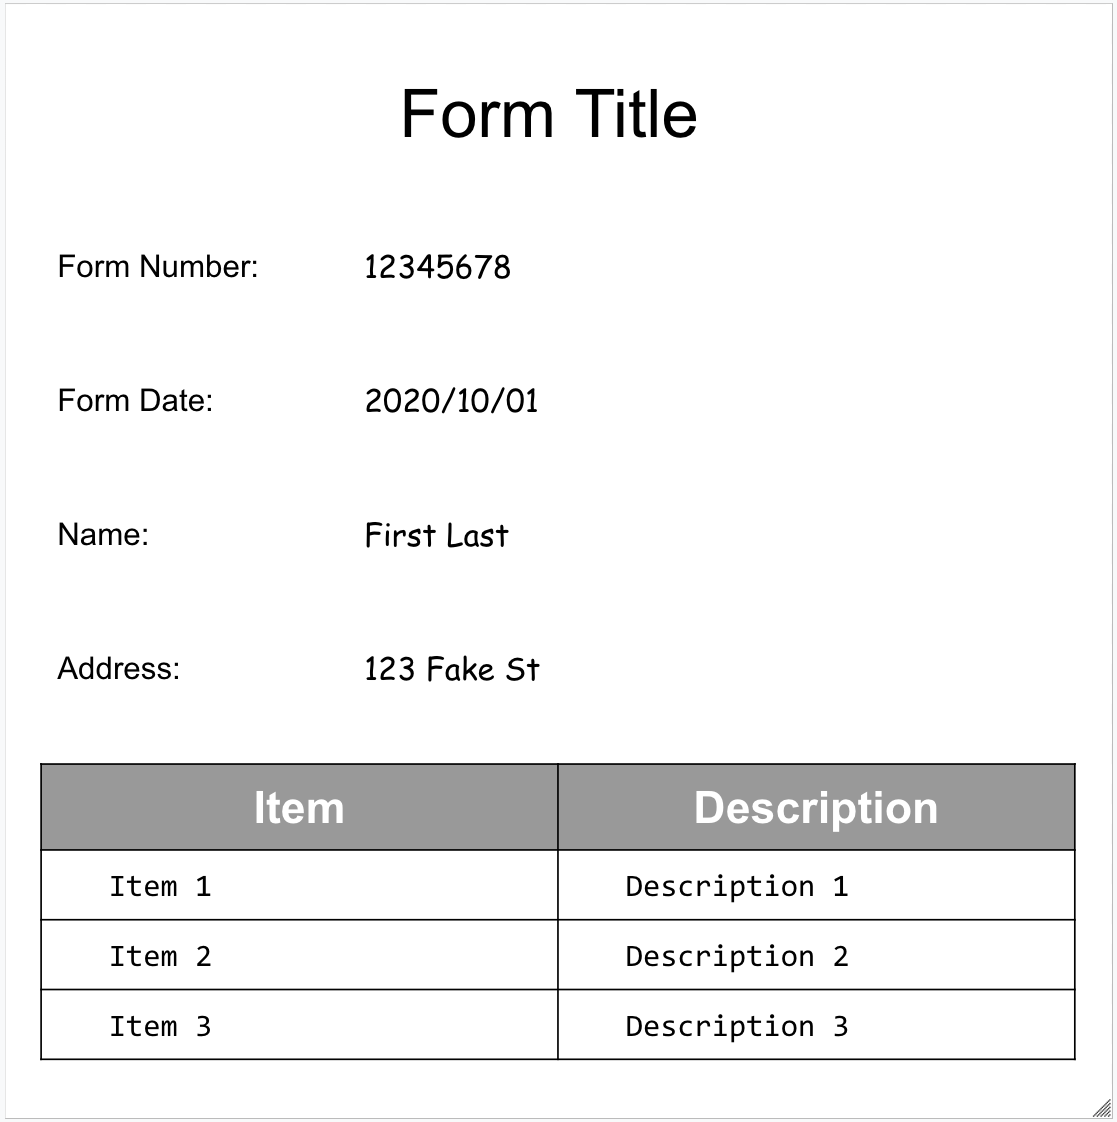
Berikut adalah objek dokumen lengkap seperti yang ditampilkan oleh Form Parser:
Berikut beberapa kolom penting:
Parser Formulir dapat mendeteksi FormFields
di halaman. Setiap kolom formulir memiliki nama dan nilai. Ini juga disebut
pasangan nilai kunci (KVP). Perhatikan bahwa KVP berbeda dengan entity (skema) di
ekstraktor lain:
Nama entity dikonfigurasi. Kunci dalam KVP adalah teks kunci yang ada di dokumen.
{
  "pages:" [
    {
      "formFields": [
        {
          "fieldName": { ... },
          "fieldValue": { ... }
        }
      ]
    }
  ]
}
- Document AI juga dapat mendeteksi
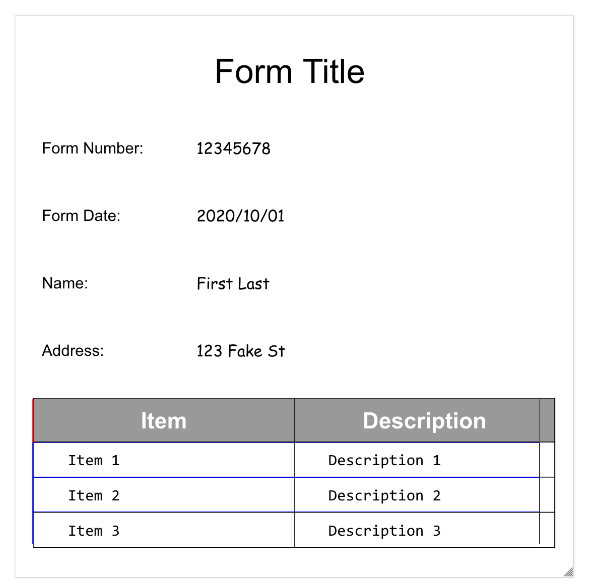
Tablesdi halaman.
{
  "pages:" [
    {
      "tables": [
        {
          "layout": { ... },
          "headerRows": [
            {
              "cells": [
                {
                  "layout": { ... },
                  "rowSpan": 1,
                  "colSpan": 1
                },
                {
                  "layout": { ... },
                  "rowSpan": 1,
                  "colSpan": 1
                }
              ]
            }
          ],
          "bodyRows": [
            {
              "cells": [
                {
                  "layout": { ... },
                  "rowSpan": 1,
                  "colSpan": 1
                },
                {
                  "layout": { ... },
                  "rowSpan": 1,
                  "colSpan": 1
                }
              ]
            }
          ]
        }
      ]
    }
  ]
}
Ekstraksi tabel dalam Form Parser hanya mengenali tabel konvensional,
yang tidak memiliki sel yang mencakup baris atau kolom. Jadi, rowSpan dan colSpan selalu 1.
Mulai dari versi pemroses
pretrained-form-parser-v2.0-2022-11-10, Form Parser juga dapat mengenali entity umum. Untuk mengetahui informasi selengkapnya, lihat Form Parser.Untuk membantu Anda memvisualisasikan struktur dokumen, gambar berikut menggambar poligon pembatas untuk
page.formFieldsdanpage.tables.Kotak centang dalam tabel. Parser Formulir dapat mendigitalkan kotak centang dari gambar dan PDF sebagai KVP. Memberikan contoh digitalisasi kotak centang sebagai key-value pair.
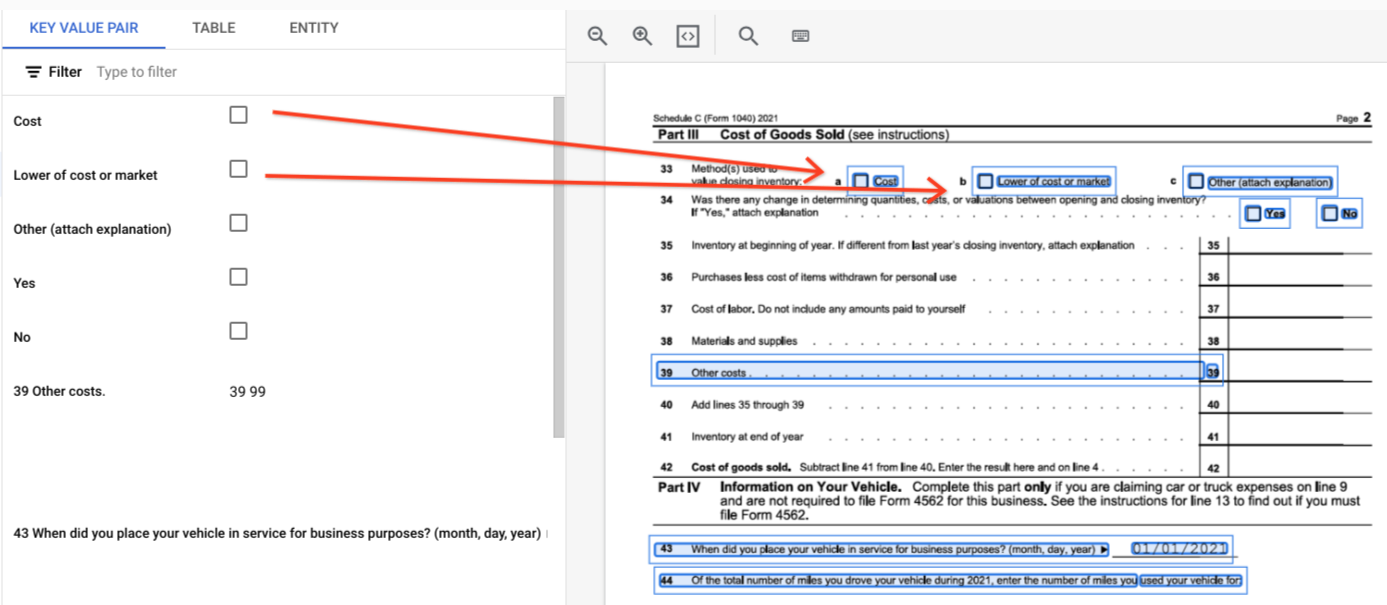
Di luar tabel, kotak centang direpresentasikan sebagai elemen visual dalam Form Parser. Menandai kotak persegi yang memiliki tanda centang di UI dan unicode ✓ di JSON.

"pages:" [
    {
      "tables": [
        {
          "layout": { ... },
          "headerRows": [
            {
              "cells": [
                {
                  "layout": { ... },
                  "rowSpan": 1,
                  "colSpan": 1
                },
                {
                  "layout": { ... },
                  "rowSpan": 1,
                  "colSpan": 1
                }
              ]
            }
          ],
          "bodyRows": [
            {
              "cells": [
                {
                  "layout": { ... },
                  "rowSpan": 1,
                  "colSpan": 1
                },
                {
                  "layout": { ... },
                  "rowSpan": 1,
                  "colSpan": 1
                }
              ]
            }
          ]
        }
      ]
    }
  ]
}
Dalam tabel, kotak centang muncul sebagai karakter Unicode seperti ✓ (dicentang) atau ☐ (tidak dicentang).
Kotak centang yang terisi memiliki nilai sebagai filled_checkbox:
under pages > x > formFields > x > fieldValue > valueType.. Kotak centang yang tidak dicentang memiliki nilai unfilled_checkbox.
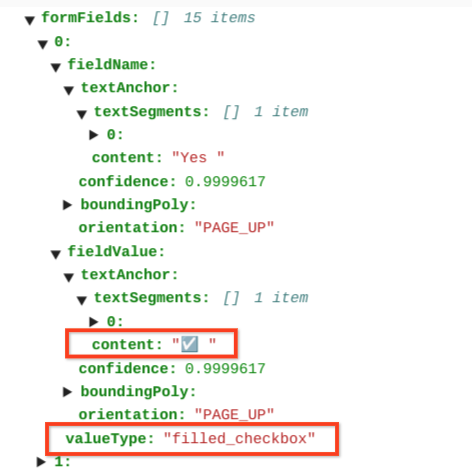
Kolom konten menampilkan nilai konten kotak centang yang ditandai ✓ di
jalur pages>formFields>x>fieldValue>textAnchor>content.
Untuk membantu Anda memvisualisasikan struktur dokumen, gambar berikut menggambar poligon pembatas untuk page.formFields dan page.tables.
Kolom Formulir
Tabel
Contoh kode
Contoh kode berikut menunjukkan cara mengirim permintaan pemrosesan, lalu membaca dan mencetak kolom ke terminal:
Java
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Java Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Node.js
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Node.js Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Python
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Python Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Entity, entity bertingkat, dan nilai yang dinormalisasi
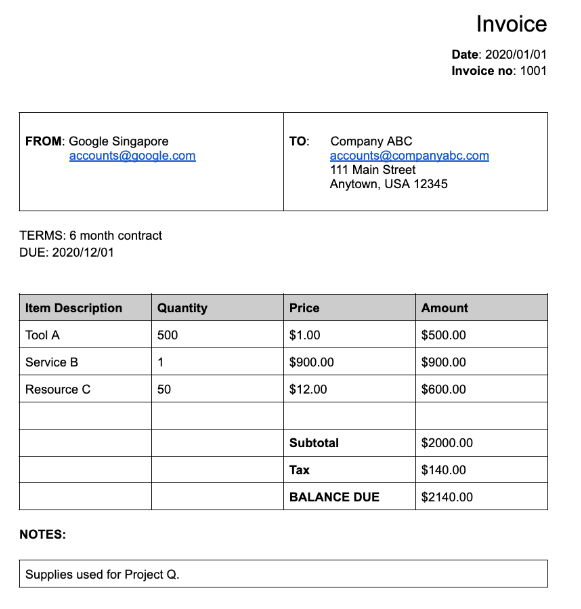
Banyak pemroses khusus mengekstrak data terstruktur yang di-grounding ke skema yang didefinisikan dengan baik. Misalnya, Parser invoice
mendeteksi kolom tertentu seperti invoice_date dan supplier_name. Berikut adalah
contoh invoice:
Berikut adalah objek dokumen lengkap seperti yang ditampilkan oleh Invoice parser:
Berikut adalah beberapa bagian penting dari objek dokumen:
Kolom yang terdeteksi:
Entitiesberisi kolom yang dapat dideteksi oleh pemroses, misalnya,invoice_date:{ "entities": [ { "textAnchor": { "textSegments": [ { "startIndex": "14", "endIndex": "24" } ], "content": "2020/01/01" }, "type": "invoice_date", "confidence": 0.9938466, "pageAnchor": { ... }, "id": "2", "normalizedValue": { "text": "2020-01-01", "dateValue": { "year": 2020, "month": 1, "day": 1 } } } ] }Untuk kolom tertentu, pemroses juga menormalisasi nilai. Dalam contoh ini, tanggal telah dinormalisasi dari
2020/01/01menjadi2020-01-01.Normalisasi: Untuk banyak kolom tertentu yang didukung, pemroses juga menormalisasi nilai dan juga menampilkan
entity. KolomnormalizedValueditambahkan ke kolom mentah yang diekstrak yang diperoleh melaluitextAnchordari setiap entity. Jadi, tokenisasi menormalisasi teks literal, sering kali memecah nilai teks menjadi subkolom. Misalnya, tanggal seperti 1 September 2024 akan direpresentasikan sebagai:
  normalizedValue": {
    "text": "2020-09-01",
    "dateValue": {
      "year": 2024,
      "month": 9,
      "day": 1
  }
Dalam contoh ini, tanggal telah dinormalisasi dari 2020/01/01 menjadi 2020-01-01, format standar untuk mengurangi pascapemrosesan dan memungkinkan konversi ke format yang dipilih.
Alamat juga sering dinormalisasi, yang membagi elemen alamat menjadi kolom-kolom tersendiri. Angka dinormalisasi dengan memiliki bilangan bulat atau angka floating point sebagai normalizedValue.
- Pengayaan: Pemroses dan kolom tertentu juga mendukung pengayaan.
Misalnya,
supplier_nameasli dalam dokumenGoogle Singaporetelah dinormalisasi terhadap Enterprise Knowledge Graph menjadiGoogle Asia Pacific, Singapore. Perhatikan juga bahwa karena Enterprise Knowledge Graph berisi informasi tentang Google, Document AI menyimpulkansupplier_addressmeskipun tidak ada dalam dokumen contoh.
  {
    "entities": [
      {
        "textAnchor": {
          "textSegments": [ ... ],
          "content": "Google Singapore"
        },
        "type": "supplier_name",
        "confidence": 0.39170802,
        "pageAnchor": { ... },
        "id": "12",
        "normalizedValue": {
          "text": "Google Asia Pacific, Singapore"
        }
      },
      {
        "type": "supplier_address",
        "id": "17",
        "normalizedValue": {
          "text": "70 Pasir Panjang Rd #03-71 Mapletree Business City II Singapore 117371",
          "addressValue": {
            "regionCode": "SG",
            "languageCode": "en-US",
            "postalCode": "117371",
            "addressLines": [
              "70 Pasir Panjang Rd",
              "#03-71 Mapletree Business City II"
            ]
          }
        }
      }
    ]
  }
Kolom bertingkat: Skema bertingkat (kolom) dapat dibuat dengan mendeklarasikan entity sebagai induk terlebih dahulu, lalu membuat entity turunan di bawah induk. Respons penguraian untuk induk menyertakan kolom turunan dalam elemen
propertiesdari kolom induk. Dalam contoh berikut,line_itemadalah kolom induk yang memiliki dua kolom turunan:line_item/descriptiondanline_item/quantity.{ "entities": [ { "textAnchor": { ... }, "type": "line_item", "confidence": 1.0, "pageAnchor": { ... }, "id": "19", "properties": [ { "textAnchor": { "textSegments": [ ... ], "content": "Tool A" }, "type": "line_item/description", "confidence": 0.3461604, "pageAnchor": { ... }, "id": "20" }, { "textAnchor": { "textSegments": [ ... ], "content": "500" }, "type": "line_item/quantity", "confidence": 0.8077843, "pageAnchor": { ... }, "id": "21", "normalizedValue": { "text": "500" } } ] } ] }
Parser berikut mengikutinya:
- Mengekstrak (Pengekstrak Kustom)
- Lama
- Parser laporan mutasi bank
- Parser pengeluaran
- Parser Invoice
- Parser Slip Gaji
- Parser W2
Contoh kode
Contoh kode berikut menunjukkan cara mengirim permintaan pemrosesan, lalu membaca dan mencetak kolom dari pemroses khusus ke terminal:
Java
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Java Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Node.js
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Node.js Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Python
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Python Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Pengekstrak Dokumen Kustom
Prosesor Custom Document Extractor dapat mengekstrak entity kustom dari dokumen yang tidak memiliki prosesor terlatih. Hal ini dapat dilakukan dengan melatih model kustom atau menggunakan Model Dasar AI Generatif untuk mengekstrak entity bernama tanpa pelatihan apa pun. Untuk mengetahui informasi selengkapnya, lihat Membuat Pengekstrak Dokumen Kustom di konsol.
- Jika Anda melatih model kustom, pemroses dapat digunakan dengan cara yang sama persis seperti pemroses ekstraksi entity terlatih.
- Jika menggunakan model dasar, Anda dapat membuat versi pemroses untuk mengekstrak entity tertentu untuk setiap permintaan, atau Anda dapat mengonfigurasinya berdasarkan permintaan.
Untuk mengetahui informasi tentang struktur output, lihat Entity, entity bertingkat, dan nilai yang dinormalisasi.
Contoh kode
Jika Anda menggunakan model kustom atau membuat versi pemroses menggunakan model dasar, gunakan contoh kode ekstraksi entity.
Contoh kode berikut menunjukkan cara mengonfigurasi entity tertentu untuk Custom Document Extractor model dasar berdasarkan permintaan dan mencetak entity yang diekstrak:
Python
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Python Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Ringkasan
Pemroses Summarizer menggunakan Model Dasar AI Generatif untuk meringkas teks yang diekstrak dari dokumen. Panjang dan format respons dapat disesuaikan dengan cara berikut:
- Panjang
BRIEF: Ringkasan singkat yang terdiri dari satu atau dua kalimatMODERATE: Ringkasan sepanjang paragrafCOMPREHENSIVE: Opsi terpanjang yang tersedia
- Format
Anda dapat membuat versi pemroses untuk panjang dan format tertentu, atau Anda dapat mengonfigurasinya berdasarkan permintaan.
Teks yang diringkas akan muncul di Document.entities.normalizedValue.text. Anda dapat menemukan contoh file JSON output lengkap di Contoh output pemroses.
Untuk mengetahui informasi selengkapnya, lihat Membuat peringkas dokumen di konsol.
Contoh kode
Contoh kode berikut menunjukkan cara mengonfigurasi panjang dan format tertentu dalam permintaan pemrosesan dan mencetak teks yang diringkas:
Python
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Python Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Pemisahan dan klasifikasi
Berikut adalah PDF gabungan 10 halaman yang berisi berbagai jenis dokumen dan formulir:
Berikut adalah objek dokumen lengkap seperti yang ditampilkan oleh pemisah dan pengklasifikasi dokumen pinjaman:
Setiap dokumen yang terdeteksi oleh pemisah diwakili oleh
entity. Contoh:
  {
    "entities": [
      {
        "textAnchor": {
          "textSegments": [
            {
              "startIndex": "13936",
              "endIndex": "21108"
            }
          ]
        },
        "type": "1040se_2020",
        "confidence": 0.76257163,
        "pageAnchor": {
          "pageRefs": [
            {
              "page": "6"
            },
            {
              "page": "7"
            }
          ]
        }
      }
    ]
  }
Entity.pageAnchormenunjukkan bahwa dokumen ini terdiri dari 2 halaman. Perhatikan bahwapageRefs[].pageberbasis nol dan merupakan indeks ke dalam kolomdocument.pages[].Entity.typemenentukan bahwa dokumen ini adalah formulir 1040 Schedule SE. Untuk mengetahui daftar lengkap jenis dokumen yang dapat diidentifikasi, lihat Jenis dokumen yang diidentifikasi dalam dokumentasi pemroses.
Untuk mengetahui informasi selengkapnya, lihat Perilaku pemisah dokumen.
Contoh kode
Pemisah mengidentifikasi batas halaman, tetapi tidak benar-benar memisahkan dokumen input untuk Anda. Anda dapat menggunakan Document AI Toolbox untuk memisahkan file PDF secara fisik menggunakan batas halaman. Contoh kode berikut mencetak rentang halaman tanpa memisahkan PDF:
Java
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Java Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Node.js
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Node.js Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Python
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Python Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Document yang diproses.
Python
Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Python Document AI.
Untuk melakukan autentikasi ke Document AI, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Toolbox Document AI
Document AI Toolbox adalah SDK untuk Python yang menyediakan fungsi utilitas untuk mengelola, memanipulasi, dan mengekstrak informasi dari respons dokumen.
Library ini membuat objek dokumen "yang digabungkan" dari respons dokumen yang diproses dari file JSON di
Cloud Storage, file JSON lokal, atau output langsung dari metode
process_document().
Agen ini dapat melakukan tindakan berikut:
- Gabungkan file JSON
Documentyang terfragmentasi dari Batch Processing menjadi satu dokumen "gabungan". - Ekspor shard sebagai
Documentterpadu. -
Dapatkan output
Documentdari: - Akses teks dari
Pages,Lines,Paragraphs,FormFields, danTablestanpa menangani informasiLayout. - Telusuri
Pagesyang berisi string target atau cocok dengan ekspresi reguler. - Telusuri
FormFieldsberdasarkan nama. - Telusuri
Entitiesmenurut jenis. - Mengonversi
Tableske Dataframe Pandas atau CSV. - Sisipkan
EntitiesdanFormFieldske dalam tabel BigQuery. - Memisahkan file PDF berdasarkan output dari pemroses Splitter/Classifier.
- Ekstrak gambar
EntitiesdariDocumentkotak pembatas. -
Mengonversi
Documentske dan dari format yang umum digunakan:- Cloud Vision API
AnnotateFileResponse - hOCR
- Format pemrosesan dokumen pihak ketiga
- Cloud Vision API
- Membuat batch dokumen untuk diproses dari folder Cloud Storage.
Contoh Kode
Contoh kode berikut menunjukkan cara menggunakan Document AI Toolbox.