


Patch gecesinden önce sanal makinelerin snapshot'ını almak yaygın bir alışkanlık. İşler biter, snapshot'lar yerinde kalır ve silmeyi çoğu zaman kimse hatırlamaz. Zabbix her VM için ayrı bir "snapshot eskidi" problemi açarsa, birkaç gün sonra ekranda onlarca problem ve onlarca ticket birikir. Sorun snapshot'ların kendisi değil, aynı sebebin her VM için ayrı ayrı bağırması.
Bunu kendi lab'ımda deneyerek çözmek istedim ve iki hedef koydum. Birincisi, bu alarm yağmurunun yerine tek bir uyarı. İkincisi, Zabbix agent kurmadan, sadece hipervizörün üzerinden, bir Windows VM'in C: diski dolmak üzereyse haber almak.
Hepsini evdeki Proxmox lab'ımda, kendi kurduğum bir Zabbix'te denedim. Bu yazıda çalışan kısmı da, yolda yaptığım yanlışları da olduğu gibi gösteriyorum. Kısaca: Zabbix'in hazır Proxmox template'i disk kısmını zaten çözüyor; snapshot kısmı için ise kendi yazdığım küçük bir script gerekti. Sonra asıl zor soru geldi: onlarca alarmın tek bir mailde nasıl toplanacağı. Konu büyüdüğü için bunu bir seriye böldüm, bu ilk bölüm.
Lab ve sadece okuyabilen bir kullanıcı
Lab'ım şu: üç node'lu bir Proxmox VE 9.2.2 cluster'ı (pve-a, pve-b, pve-c ve bir QDevice) ve bu cluster'ın üzerinde, VM 104 olarak çalışan bir Rocky Linux 10.2. Zabbix 7.4.16'yı bu Rocky'ye kurdum. İzlenen taraf Proxmox'un kendisi, yani Zabbix hem kendi üzerinde çalışan cluster'ı izliyor. Lab için sorun değil, gerçek ortamda Zabbix'i izlediği cluster'ın dışına koymak daha doğru olur.
Zabbix'in Proxmox'la konuşması için root hesabını vermek akıllıca değil. Sadece okuyabilen bir kullanıcı, bir rol ve bir API token'ı açtım:
pveum user add zabbix@pve --comment "Zabbix monitoring"
pveum role add ZabbixMonitor --privs "Sys.Audit,Datastore.Audit,VM.Audit,VM.GuestAgent.Audit"
pveum aclmod / -user zabbix@pve -role ZabbixMonitor
pveum user token add zabbix@pve zbx --privsep 1
pveum aclmod / -token 'zabbix@pve!zbx' -role ZabbixMonitor

Tüm yetkiler "Audit", yani okuma. Rol içindeki VM.GuestAgent.Audit önemli: Proxmox 9'da eski VM.Monitor yetkisi kaldırılmış ve VM'in içindeki disk bilgisini guest agent üzerinden okuyabilmek için artık bu yetki gerekiyor. Template'in de ayrıca Sys.Audit (/ üzerinde), Datastore.Audit (/storage) ve VM.Audit (/vms) istediğini gördüm; ben lab'da hepsini / üzerinden verdim, gerçekte yolları daraltmak daha temiz olur.
--privsep 1 ile açılan token'ın yetkisi kullanıcınınkinden ayrı tutuluyor, o yüzden son satırdaki ikinci aclmod zorunlu gerekiyor; token'a ayrıca rol atamazsan kendi başına yetkisi olmaz. Token secret'ı yalnızca bir kere gösteriliyor, hemen bir yere not al.
Token'ı curl ile denerken ilk tuzağımı bash'in kendisi kurdu: zabbix@pve!zbx içindeki !, çift tırnak içinde history expansion yapıp event not found hatası verdi. Tek tırnak kullanınca geçti:
curl -sk -H 'Authorization: PVEAPIToken=zabbix@pve!zbx='$SECRET https://192.168.122.11:8006/api2/json/version

Template'i bağlamak kolay, güvenmek zor
Zabbix 7.4 ile zaten hazır bir Proxmox VE by HTTP template'i geliyor. Bunu pve-lab host'una (grup: Proxmox) bağladım ve host'un Macros sekmesine dört değer girdim: {$PVE.URL.HOST}, {$PVE.URL.PORT}, {$PVE.TOKEN.ID} ve {$PVE.TOKEN.SECRET}. Token secret'ı secret tipinde macro olarak sakla ki arayüzde görünmesin.
Mimariyi netleştireyim, çünkü yazının geri kalanı buna dayanıyor: izlenen hiçbir sanal makineye Zabbix agent kurmadım. Zabbix sunucusu yalnızca Proxmox'un REST API'siyle konuşuyor; token'ı kullanarak cluster'ı, node'ları, VM'leri ve snapshot'ları oradan okuyor. VM'in içindeki disk bilgisi de yine Proxmox API'si üzerinden geliyor (agent/get-fsinfo), ama bu bilgiyi toplayan, VM'in içinde zaten çalışan QEMU guest agent. Yani veri yolu şöyle: VM'deki QEMU guest agent, oradan Proxmox API'si, oradan Zabbix. Tek ön koşul, VM'de QEMU guest agent'ın kurulu ve çalışıyor olması.
Kısa sürede Latest data'da yüzlerce item belirdi. Sevindim, ta ki dashboard'lara bakana kadar: node bilgileri geliyordu, ama cluster, VM ve LXC panelleri sıfır ya da boştu. zabbix_server.log sebebi tek satırda söylüyordu:
SSL certificate problem: unable to get local issuer certificate
Template'in asıl veriyi toplayan master item'ı ("Cluster: Get resources") bir Script item ve TLS sertifikasını doğrular. Proxmox'un kendi imzaladığı CA'sına Rocky güvenmediği için item düştü. İlgin bir yan etki: HTTP agent item'ları aynı sertifika sorununa rağmen düşmedi, yani yarım veri gelince sorunu ilk bakışta anlamak zor oluyor. Çözüm, Proxmox'un root CA'sini Rocky'nin güven listesine eklemek:
scp root@192.168.122.11:/etc/pve/pve-root-ca.pem /tmp/pve-root-ca.pem
cp /tmp/pve-root-ca.pem /etc/pki/ca-trust/source/anchors/pve-root-ca.crt
update-ca-trust
systemctl restart zabbix-server
Bir iki toplama turu sonra cluster, VM ve LXC panelleri doldu. Doğrulamayı kapatmak (insecure) yerine CA'ya güvenmeyi seçtim; gerçek ortamda da bunu öneririm.
Temizlenmeyen iki şey kaldı. hardware.usb ve updates item'ları üç node'da da 403 verdi. Büyük ihtimalle token'ın yetkisi o uçlara yetmiyor, ama sebebini ayrıca kontrol etmedim; ikisi de benim senaryomla ilgili olmadığı için bıraktım (istersen item'ları kapatabilirsin). İkincisi, ilk toplama turunda bazı utilization item'ları "not enough data" ile düşüp bir iki dakika içinde kendiliğinden düzeldi; bu ilk veri gelene kadar normal.

Agent kurmadan C: diskini izlemek
İkinci hedefim, Windows VM'in içine Zabbix agent kurmadan C: doluluk alarmıydı. Bunun yolu Proxmox'un guest agent üzerinden verdiği dosya sistemi bilgisi: agent/get-fsinfo. Template'in QEMU filesystem discovery kuralı tam olarak bunu kullanıyor, yani ek bir şey yazmam gerekmedi. Dikkat edilecek nokta "agentsiz" kelimesi: Zabbix agent gerekmiyor, ama VM'in içinde QEMU guest agent'ın çalışıyor olması şart. Gerçek bir ortamda bunun zaten kurulu olup olmadığını önce kontrol etmek lazım.
Linux tarafı: alpine-b. İlk denemede hem komutu hem de VM'in hangi node'da olduğunu yanlış verdim. Proxmox API'sine herhangi bir node'un adresiyle bağlanabiliyorsun, ama yolda geçen node adı VM'in gerçekte çalıştığı node olmak zorunda. 102 numaralı VM pve-b üzerindeydi, ben pve-a yazdığım için hata döndü. Bir de VM'in ayarlarında agent açık değilmiş:
qm set 102 --agent enabled=1
Bu ayar çalışan VM'e hemen uygulanmıyor, VM'i kapatıp açınca devreye giriyor. Doğru node ile çağırınca guest agent / ve /boot bilgilerini döndü:
curl -sk -H 'Authorization: PVEAPIToken=zabbix@pve!zbx='$SECRET \
  https://192.168.122.11:8006/api2/json/nodes/pve-b/qemu/102/agent/get-fsinfo
Zabbix'teki hesaplanan kullanım yüzdelerini JSON'daki bayt değerlerinden elle hesapladığımla karşılaştırdım: / için %1,5943, /boot için %15,5879, ikisi de tuttu.
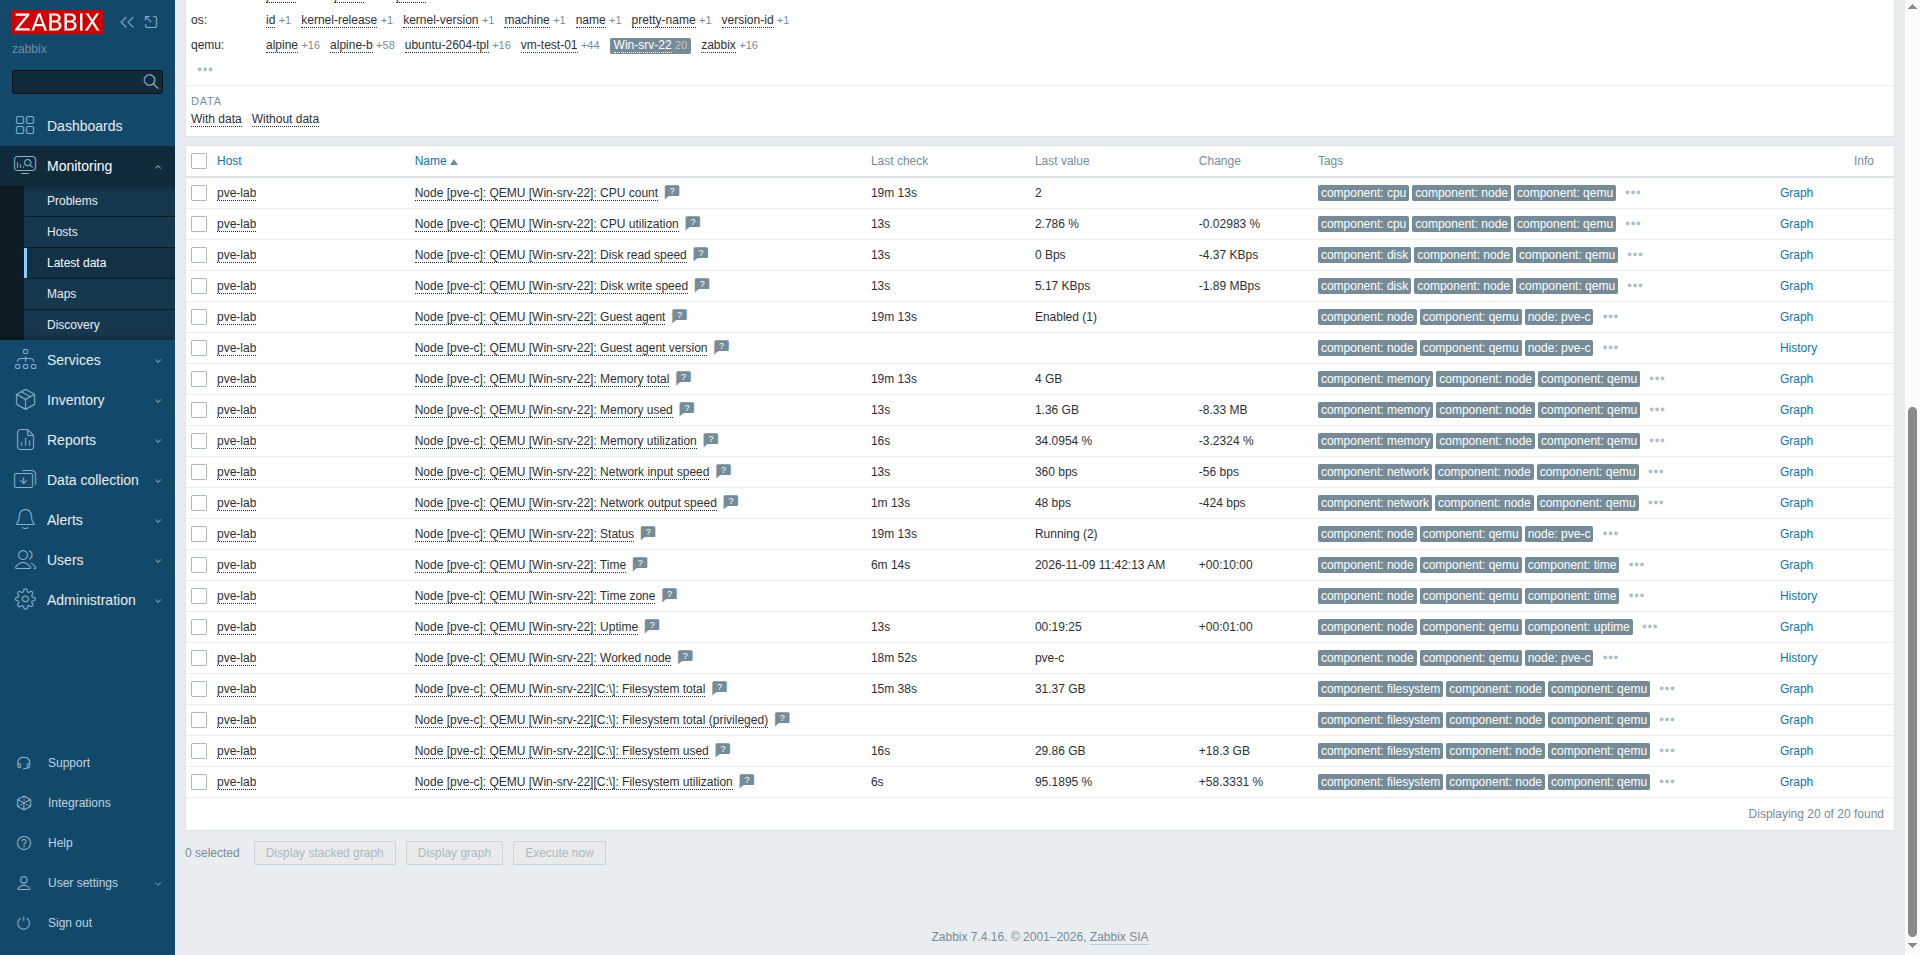
Windows tarafı: Win-srv-22. Windows Server 2022'yi kurup QEMU guest agent'ı yükledim (servis QEMU-GA, PowerShell'de Get-Service QEMU-GA ile Running gördüm). VM pve-c üzerinde. Discovery bir süre sonra C: ile ilgili item'ları getirdi: toplam 31,37 GB. Ama listede C: dışında küçük "System Reserved" bölümleri de vardı; aynı isimle tekrar ediyorlar ve yüzde 84 gibi dolu görünüyorlar, yani gerçek bir sorun olmadan alarm üretmeye aday. Bunun için template'in kendi filtre macro'su var; host'a şunu girdim:
{$PVE.FILTER.QEMU.FS.MOUNT_POINT.NOTMATCH} = System Reserved
Bir de Windows'ta total-bytes-privileged alanı gelmedi, Linux'ta vardı. Bu yüzden "Filesystem total (privileged)" item'ı boş kalıyor; kullanım yüzdesi bundan etkilenmedi.
Alarmı denemek. Diski doldurmak için C: üzerinde büyük bir dosya oluşturdum:
fsutil file createnew C:\fill.bin <bayt>
Kullanım yaklaşık %93'e çıktı ve Zabbix Warning açtı: Proxmox VE: Node [pve-c]: QEMU [Win-srv-22][C:\]: Filesystem used high. Dosyayı silince (del C:\fill.bin) problem kendiliğinden kapandı; açılıştan kapanışa toplam altı dakika sürdü. Agent kurmadan, sadece Proxmox API'si üzerinden yapılan bir disk doluluğu alarmının açılıp kapandığını görmek istediğim buydu.

Snapshot sorunu: çok sayıda item yerine tek bir tarama
Snapshot yaşı için template'te hazır bir item yok, o yüzden Proxmox API'sini tarayan küçük bir Script item yazdım. Çalışma mantığı şöyle.
Proxmox snapshot'ları kümülatif tutuyor ve hiçbir zaman kendiliğinden silmiyor. Her snapshot'ın adı ve snaptime alanında epoch cinsinden oluşturulma zamanı var; current adındaki satır ise snapshot değil, "şu an buradasınız" işareti, onu atlamak gerekiyor. Script önce cluster/resources ile tüm VM ve LXC'leri listeliyor, şablon olanları ayıklayıp her birinin snapshot listesine bakıyor, yaşı hesaplıyor ve tek bir JSON özeti döndürüyor.
Zabbix'te bunu Proxmox: Snapshot summary adında bir Script item olarak (proxmox.snapshots.summary) kurdum. Parametreler macro'lardan geliyor: host, port, token_id, token_secret ve max_age (saniye). Timeout'u 30 saniyeye çektim; Type of information'ı Text yapmak lazım, ilk denemede Numeric kaldığı için JSON çıktısı hata verdi.
// Proxmox snapshot yasi - Zabbix 7.4 Script item
// Script parameters: host, port, token_id, token_secret, max_age (saniye)
var p = JSON.parse(value);
var base = 'https://' + p.host + ':' + p.port + '/api2/json';
var maxAge = parseInt(p.max_age, 10);
if (isNaN(maxAge)) { throw 'max_age sayi degil: ' + p.max_age; }

var req = new HttpRequest();
req.addHeader('Authorization: PVEAPIToken=' + p.token_id + '=' + p.token_secret);

function get(path) {
    var body = req.get(base + path);
    var status = req.getStatus();
    if (status !== 200) {
        throw 'HTTP ' + status + ' for ' + path;
    }
    return JSON.parse(body).data;
}

var now = Math.floor(Date.now() / 1000);
var resources = get('/cluster/resources?type=vm');

var result = {
    vms_checked: 0, snapshots: 0,
    oldest_age: 0, oldest_vm: '', oldest_name: '',
    over_count: 0, over_list: '', errors: 0
};
var over = [];

resources.forEach(function (r) {
    // Sadece qemu ve lxc; sablon (template) VM'leri atla
    if ((r.type !== 'qemu' && r.type !== 'lxc') || r.template === 1) {
        return;
    }
    result.vms_checked++;

    var list;
    try {
        list = get('/nodes/' + r.node + '/' + r.type + '/' + r.vmid + '/snapshot');
    } catch (e) {
        result.errors++;
        return;
    }

    var vmOver = 0;
    list.forEach(function (s) {
        // 'current' gercek snapshot degil, "You are here!" satiri
        if (s.name === 'current' || !s.snaptime) {
            return;
        }
        result.snapshots++;
        var age = now - s.snaptime;
        if (age > result.oldest_age) {
            result.oldest_age = age;
            result.oldest_vm = r.name;
            result.oldest_name = s.name;
        }
        if (age > maxAge) {
            vmOver++;
            result.over_count++;
        }
    });
    if (vmOver > 0) {
        over.push(r.name + ' (' + vmOver + ')');
    }
});

result.over_list = over.join(', ').substring(0, 500);
return JSON.stringify(result);
Bu script'in ilk hali bir hatayı sessizce yutuyordu ve ben bunu ancak denerken fark ettim. Host'ta {$SNAP.MAX.AGE} macro'sunu tanımlamamıştım; script de max_age'i sayıya çeviremeyince age > NaN karşılaştırmasının hep yanlış çıkması yüzünden over_count: 0 döndü. Yani her şey yolundaymış gibi görünüyordu. Yukarıdaki isNaN satırı o yüzden orada: macro eksikse script artık açık bir hata atıyor.
Master item her turda bu JSON'u üretiyor, ben de ondan iki dependent item türettim (JSONPath preprocessing ile): proxmox.snapshots.over_count ($.over_count) ve proxmox.snapshots.over_list ($.over_list). Trigger bunlara bakıyor:
last(/pve-lab/proxmox.snapshots.over_count)>0 and length(last(/pve-lab/proxmox.snapshots.over_list))>0
Adı Proxmox: Eşikten eski snapshot var, önem derecesi Warning. Onlarca VM'de onlarca snapshot olsa da bu tek bir problem açıyor; hangi VM'lerde kaç tane olduğu over_list içinde. Liste 500 karakterde kesiliyor, çok sayıda VM'in hepsini sığdıramaz; gerçek ortamda "en çok snapshot'ı olan ilk 10 VM ve N tane daha" şeklinde kısaltmak daha akıllıca olur.
Trigger adında sayıyı gösterme denemem de bir ders oldu. İlk adın içine {ITEM.LASTVALUE} koymuştum; problem açıldığı andaki sayı başlıkta donup kaldı. 10 snapshot'lık bir problem, sonradan 13 olsa da "10 snapshot" yazıyordu. Sayyı başlıktan çıkarıp Operational data alanına taşıdım: {ITEM.LASTVALUE1} snapshot: {ITEM.LASTVALUE2}. Problems sayfasında "Show operational data: Separately" seçilince bu alan canlı güncelleniyor.
Bir davranış daha dikkat çekti. Bir VM'e yeni snapshot alınıp eski silinmezse problem kapanmıyor; çünkü script tüm snapshot'lara yaşlarına göre bakıyor ve eşiği aşan hiçbir tane kalmayınca çözülüyor. İlk başta bunu bir hata sanıp "neden çözüldü görünmüyor" diye bakındım, sonra anladım ki bunun doğru davranış olduğunu: eski snapshot disk yer tutmaya devam ediyor, yeni snapshot onun yerini almaz.

İki kademeli eşik: önce hatırlat, sonra çığlık at
Tek bir eşik yetmiyor; istediğim önce nazik bir hatırlatma ("bir gündür snapshot duruyor"), üç gün geçince de asıl alarm. Bunun için iki host macro'su kullandım ve lab'da süreleri kısalttım ki test edebileyim:

| Macro | Lab | Üretim |
|---|---|---|
{$SNAP.WARN.AGE} |
120 sn | 86400 sn (1 gün) |
{$SNAP.MAX.AGE} |
300 sn | 259200 sn (3 gün) |
İkinci kademe zaten vardı; over_count trigger'ı {$SNAP.MAX.AGE}'i aşan snapshot'larda Warning veriyordu. İlk kademe için script'in döndürdüğü JSON'dan üç dependent item daha çıkardım: oldest_age (sayı, birimi s), oldest_vm ve oldest_name (ikisi Text). Information trigger'ı sadece oldest_age'e bakıyor:
last(/pve-lab/pve.snap.oldest_age)>{$SNAP.WARN.AGE} and last(/pve-lab/pve.snap.oldest_age)<={$SNAP.MAX.AGE}
Burada üst sınırı bilerek koydum. Information yalnızca iki eşik arasındayken açık kalıyor, Warning devreye girince kendiliğinden kapanıyor. Böylece aynı snapshot için ekranda iki seviye birden durmuyor. Adı Eski snapshot var, Operational data'ya ise Yaş: {ITEM.LASTVALUE1} yazdım; item birimi s olduğu için Zabbix süreyi kendisi "2m 43s" diye biçimliyor, sonuna ayrıca "sn" yazmaya gerek yok.

Deneme basit: 102 numaralı VM'de snapshot alıp bekledim. Snapshot yaklaşık 2,5 dakikalık olunca Information açıldı; 5,5 dakikayı geçince Information kapandı ve aynı saniyede Warning açıldı; snapshot'ı silince Warning de kapandı. Yani döngü beklenen sırayla işledi.
Bu arada bir noktada her kademe için iki ayrı trigger kalmıştı (denemelerden artakalanlar). Problems sayfasında aynı olay için iki problem açıldığını görünce fark ettim; bildirim bağlayınca aynı olay için iki mail gitmesin diye her kademede tek trigger bıraktım. Unutmamak lazım: oldest_age tüm cluster'daki en eski tek snapshot'ın yaşı. Bu eşik "cluster'da bir yerde eski bir snapshot var" demek, "şu projenin şu VM'i" demek değil. Proje ya da ekip bazında ayırmak sonraki bölümlerin işi.

Çok sayıda alarmı tek maile sığdırmak
Asıl hedefim şuydu: kısa bir aralıkta, örneğin 18:00 ile 18:24 arasında çok sayıda VM'in snapshot'ı eşiği aşarsa her biri için ayrı mail değil, 15 ile 20 dakikalık bir bekleme sonrası tek bir mesaj gelsin. Bildiğim kadarıyla Zabbix farklı problemleri kendiliğinden tek mesajda birleştirmez, escalation her olay için ayrı çalışır. Ama bizim tasarımımızda zaten VM başına ayrı olay yok: cluster için tek bir problem var, VM listesi de problemin içinde. Geriye mesajın ne zaman gideceğini ayarlamak kalıyor.
Kanal: Gmail. Kurumsal ortamlarda mail hala en geçerli kanal, o yüzden Gmail SMTP ile başladım. Normal şifreyle olmuyor; hesapta 2 adımlı doğrulama açıkken myaccount.google.com/apppasswords adresinden bir uygulama şifresi üretmek gerekiyor. Zabbix'te Alerts → Media types → Email'i açıp şunları girdim:
| Alan | Değer |
|---|---|
| SMTP server | smtp.gmail.com |
| SMTP server port | 587 |
| Connection security | STARTTLS |
| Authentication | Username and password |
| Username | Gmail adresi |
| Password | Uygulama şifresi (boşluksuz) |
| Message format | HTML |
Media type'ın satırındaki Test düğmesiyle kendime mail attım, geldi. Sonra Users → Admin → Media'dan kendi adresimi bu media type ile ekledim; bunu atladığımda ilk gerçek denemede Problems sayfasında Failed: No media defined for user hatasını gördüm. Mail yolu Zabbix'te iki ayrı yerden kurulur: media type (nasıl gönderilir) ve kullanıcının media'si (kime).
Mail şablonu. Gmail, mailin içindeki <style> bloklarını ve dış CSS'i güvenilir biçimde işlemiyor, o yüzden stilleri her etikette style="..." olarak yazdım. Media type'ın Message templates sekmesinde Problem şablonu (Subject: [{EVENT.SEVERITY}] {EVENT.NAME}):
<div style="font-family:Arial,Helvetica,sans-serif;max-width:560px;border:1px solid #e2e5e9;border-radius:6px;overflow:hidden">
  <div style="background:#d9534f;color:#ffffff;padding:14px 18px;font-size:16px;font-weight:bold">
    {{EVENT.NAME}.htmlencode()}
  </div>
  <table cellpadding="0" cellspacing="0" style="width:100%;font-size:14px;color:#222222">
    <tr>
      <td style="padding:10px 18px;color:#6b7280;width:110px">Önem</td>
      <td style="padding:10px 18px"><b>{{EVENT.SEVERITY}.htmlencode()}</b></td>
    </tr>
    <tr style="background:#f6f7f9">
      <td style="padding:10px 18px;color:#6b7280">Host</td>
      <td style="padding:10px 18px">{{HOST.NAME}.htmlencode()}</td>
    </tr>
    <tr>
      <td style="padding:10px 18px;color:#6b7280">Açılış</td>
      <td style="padding:10px 18px">{{EVENT.DATE}.htmlencode()} {{EVENT.TIME}.htmlencode()}</td>
    </tr>
    <tr style="background:#f6f7f9">
      <td style="padding:10px 18px;color:#6b7280">Detay</td>
      <td style="padding:10px 18px">{{EVENT.OPDATA}.htmlencode()}</td>
    </tr>
  </table>
  <div style="padding:10px 18px;font-size:12px;color:#9aa1ab">Olay ID: {{EVENT.ID}.htmlencode()}</div>
</div>
Çözüldü şablonunu da (Problem recovery) aynı düzende, yeşil başlıkla yazdım.


Bekleme süresi. Action'ı Alerts → Actions → Trigger actions'ta kurdum:
- Conditions: Event name contains
snapshotve Trigger severity ≥ Warning. İkincisini sonradan ekledim; çünkü Information, "Çözüldü" ve Warning mailleri art arda gelince üç mail birbirine karıştı: Information çözüldü diye mail gelirken asıl problem Warning'e yükselmiş oluyordu. Information artık sadece Zabbix ekranında görünüyor. - Operations sekmesinde Default operation step duration:
15m(test sırasında1mve3mkullandım). - Operation: Steps 2 - 2, Send to users: Admin, Send only to: Google mail. Adım 1'i boş bıraktım.
- Recovery operations: aynı kullanıcıya Çözüldü mesajı.
Mantık şu: problem açılınca 1. adım hemen çalışıyor ama boş; 2. adım step duration kadar sonra çalışıyor ve mesajı o zaman gönderiyor. Problem bu süre dolmadan kapanırsa escalation iptal oluyor ve hiç mail gitmiyor. 15 dakikalık bekleme, tetikleme anından sonra gelen snapshot'ların da mesajdaki sayıya yetişmesi için.
Mailde hangi sayı var? Bunu denemeden bilemezdim ve ilk tahminim yanlıştı. Merak ettiğim şuydu: {EVENT.OPDATA} mailde problem açıldığı andaki değeri mi gösteriyor, yoksa gönderim anındakini mi? İlk testim hatalıydı: problem açıldıktan sonra yeni snapshot ekleyip sayının artmasını bekledim, ama over_count sadece eşiği (burada 300 sn) aşmış snapshot'ları saydığı için yeni snapshot henüz sayılmıyordu. Doğru deney şu oldu: dört snapshot'ı aynı anda aldım, iki dakika sonra beşinciyi aldım. Warning 18:12:04'te açıldı; o anda beşinci snapshot henüz 3,5 dakikalıktı ve sayaca girmemişti, yani sayı 4'tü. Mail 3 dakika sonra gitti ve içinde şunu yazıyordu:
5 snapshot: alpine-b (5)
Yani mail, açılış anındaki değerle değil, gönderim anındaki değerle geliyor. 15 dakikalık beklemenin işe yaramasının nedeni de bu: snapshot'lar 24 dakikaya yayıldığında eşiği aşan sayı bekleme sırasında büyüyecek ve mail o günün son sayısıyla gelecek.
Bir sınırı da açıkça söyleyeyim: bunu lab'da beş snapshot ve 3 dakikalık bir beklemeyle gördüm. Onlarca VM'i ve 15 dakikalık gerçek bekleme süresini aynı şekilde denemedim, çıktıyı ona göre okuyun.
Henüz çözmediklerim
Bu düzenek cluster geneli tek bir uyarı veriyor. Daha büyük bir ortamda bunun proje, ekip ya da ortama göre ayrılması gerekir; yani "A projesinin 40 snapshot'ı" ile "B projesinin 12 snapshot'ı" ayrı mesajlar olarak gitmeli. Neyle gruplayacağımı henüz seçmedim: Proxmox etiketleri, havuzlar ya da isim önekleri aday; public cloud tarafında da kaynak etiketleri var. Proxmox'ta VM'lere etiket atanabiliyor ve API'nin cluster/resources çıktısında bir tags alanı olduğunu düşünüyorum, ama bunu henüz denemedim. Etiketi gruplama anahtarı yaparsam, aynı mantık public cloud kaynaklarının etiketlerine de uygulanabilir.
Bir de alarm gürültüsü var. Lab yeniden başladığında Problems listesi "Has been restarted" alarmlarıyla doldu: node'lar, VM'ler ve Zabbix sunucusu için ayrı ayrı, hepsinin tek bir kök sebebi vardı. Bunu azaltmak, aynı alarmın sürekli açılıp kapanmasını (flapping) engellemek ve sonunda Zabbix verisini yerel bir modelle yorumlatmak sonraki bölümlerin konusu. İkinci bölümde alarm gürültüsünden başlayacağım.


Top comments (0)